Was Maschinenstillstand
wirklich kostet.
Drei Rechnungen.
Verschleiß, Material, Rüsten. Und eine weitere Ursache, die in keiner Wartungsstatistik steht. Was sie kostet, rechnen wir hier Schritt für Schritt vor, mit Annahmen, die Sie durch Ihre eigenen ersetzen können.

Andreas Schönfeld
Geschäftsführer, Comquent GmbH
20 Jahre Industrial DevOps in Maschinenbau, Automotive und Fertigung. Schwerpunkt: CI/CD für SPS/PLC und SCADA, IT/OT-Konvergenz und die Wirtschaftlichkeit von Automatisierung.
 AI
Ein Update um
drei Uhr nachts.
Niemand weiß, was lief.
Eine Stunde Maschinenstillstand kostet vor allem den Deckungsbeitrag, den die Linie in dieser Stunde nicht erwirtschaftet. Für eine mittelständische Linie rechnen wir mit 15.000 € und leiten den Wert Posten für Posten her. Ein Teil der ungeplanten Stillstände geht auf den Software-Stand der Steuerung zurück und wird durch Versionierung, Tests und Rückrollbarkeit kürzer und seltener. Drei Rechnungen für ein Werk mit 60 Steuerungen ergeben rund 122.000 € Einsparung pro Jahr; eine Erstinvestition von 60.000 € ist nach knapp sechs Monaten zurückverdient.
Stand: September 2026 · Siemens TCOD 2024 · DORA 2024 · Modellrechnung
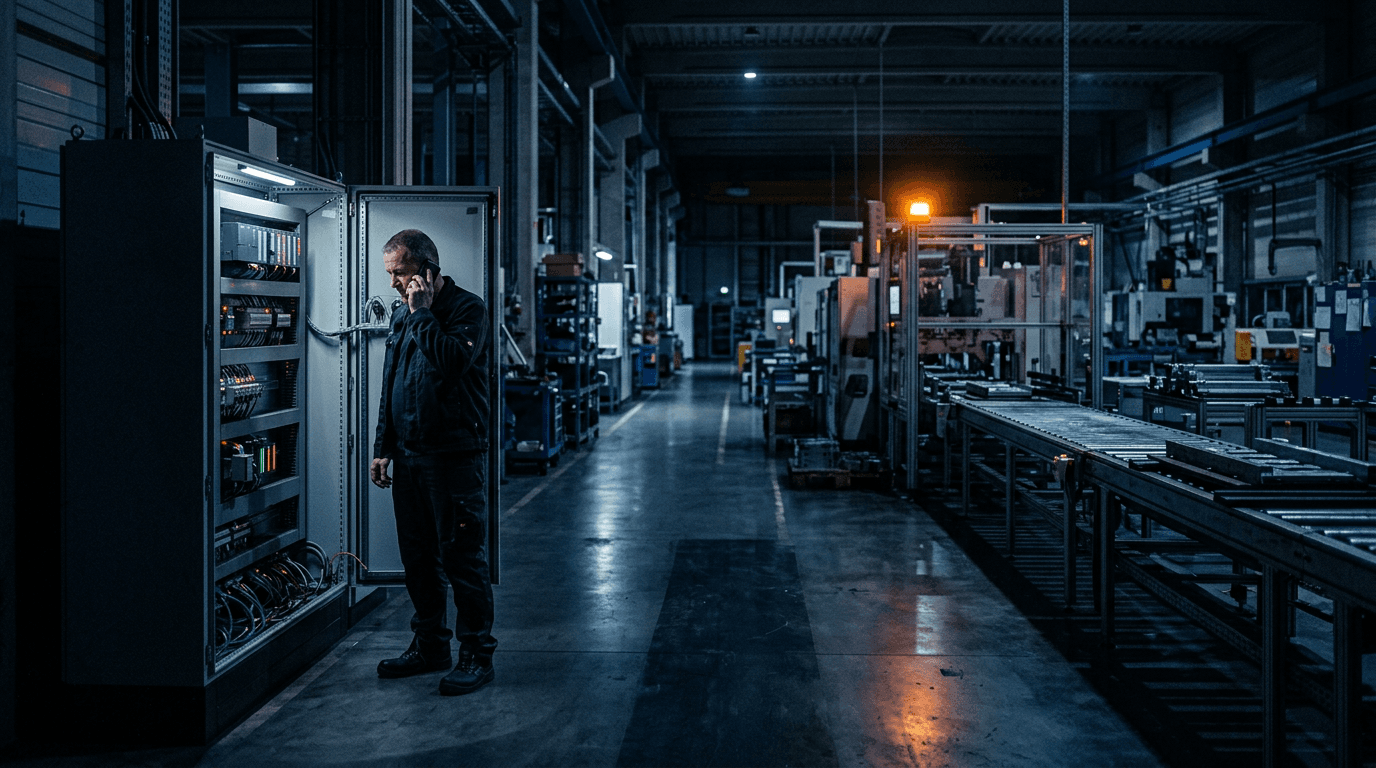
Es ist 02:47 Uhr, als die Linie 4 stehen bleibt. Ein Steuerungsupdate, von Hand auf die SPS gespielt, hat einen Parameter überschrieben, den keiner mehr rekonstruieren kann. Der Schichtleiter ruft den einzigen Kollegen an, der das System kennt. Der hat Urlaub. Der Backup-Stand auf dem Netzlaufwerk heißt Linie4_final_NEU_v3, ist vier Monate alt, und niemand weiß, ob er zur aktuellen Hardware passt. Bis die Linie wieder läuft, vergehen sechs Stunden.
Mit einem fehlenden Tool hat diese Nacht wenig zu tun. Niemand konnte sagen, was lief, wer es geändert hat und wie man zum letzten funktionierenden Stand zurückkommt. In der Störungserfassung steht am nächsten Morgen „Bedienfehler“, und damit taucht die eigentliche Ursache in keiner Auswertung auf.
 AI
Dieser Artikel rechnet nach, was solche Nächte kosten. Er geht dabei in fünf Schritten vor: Zuerst klären wir, was als Stillstand zählt und woher er kommt. Dann leiten wir her, was eine Stunde kostet. Danach folgen drei Rechnungen für die Stellen, an denen in der OT tatsächlich Geld verloren geht, nämlich ungeplante Stillstände, manuelle Rollouts und spät entdeckte Fehler. Am Ende stehen Summe, Amortisation und die Frage, was passiert, wenn unsere Annahmen zu optimistisch sind.

Wissen Sie, was eine Stunde Stillstand bei Ihnen kostet?
Eine Frage, eine Zahl. Je nachdem, ob Sie sie schon haben, zeigen wir Ihnen den nächsten sinnvollen Schritt. Ganz ohne Formular.
Was ist ein
Maschinenstillstand?
Ein Maschinenstillstand (englisch Downtime) ist jeder Zeitraum, in dem eine Produktionsanlage nicht produziert, obwohl sie laut Plan produzieren sollte. Unterschieden wird zwischen geplanten Stillständen (Wartung, Rüsten, Inspektion) und ungeplanten. Teuer sind vor allem die ungeplanten. Nach ISO 22400 zählen beide zu den Verfügbarkeitsverlusten der Gesamtanlageneffektivität (OEE).
Wie nennt man Maschinenstillstand noch anders?
Gebräuchliche Synonyme sind Downtime, Anlagenstillstand, Stillstandszeit und Ausfallzeit. Steht in der Automobilfertigung eine Montagelinie, spricht man vom Bandstillstand. Die ISO 22400 ordnet all diese Fälle den Verfügbarkeitsverlusten zu, der ersten der drei OEE-Komponenten neben Leistung und Qualität. Die Begriffe im Überblick stehen im Glossar unter Maschinenstillstand.
Was kann zu einem Maschinenstillstand führen?
Die klassischen Ursachen sind Verschleiß, Materialmangel, Rüstvorgänge und Bedienfehler. Dazu kommen Kurzstillstände, im Englischen Micro-Stops: Unterbrechungen von wenigen Minuten durch Materialstau oder blockierte Sensoren, die einzeln niemand erfasst und die sich über eine Schicht zu einem großen Posten summieren. Eine weitere Klasse wird selten benannt, obwohl sie in jeder modernen Anlage steckt, nämlich der Software-Stand der Steuerung. Gemeint sind der überschriebene Parameter, das Update ohne Rückweg und das SPS-Projekt, dessen letzter funktionierender Stand nur auf einem Netzlaufwerk liegt.
Um diese letzte Klasse geht es in den Rechnungen. Mehr Wartung und bessere Sensorik ändern an ihr nichts. Sie wird erst kürzer, wenn jeder Steuerungsstand versioniert ist und sich zurückrollen lässt. Wie eine SPS/PLC unter Versionskontrolle kommt, zeigt der Artikel Versionsverwaltung in der Industrial IT.
Ist ein softwarebedingter Stillstand ein Instandhaltungsfall?
Nein. Die Instandhaltung umfasst Wartung, Inspektion, Instandsetzung und Verbesserung an der physischen Anlage, also alles, was Verschleiß, Ersatzteile und Abnutzung betrifft. Ein falscher Steuerungsstand ist kein Schaden an einem Bauteil. Ihm fehlt ein Rückweg im Änderungsprozess der Software. In der Instandhaltungsstatistik landet er trotzdem, weil es dort keine passende Kategorie gibt.
Das hat zwei Folgen. Solange softwarebedingte Ausfälle als Bedienfehler verbucht werden, kennt niemand ihren Anteil, und was keine Zahl hat, bekommt kein Budget. Außerdem greifen die üblichen Gegenmaßnahmen daneben: Vorbeugende Wartung, zusätzliche Sensoren und ein besseres Ersatzteillager senken diesen Anteil nicht. Wer ihn sehen will, führt in der Störungserfassung eine eigene Kategorie „Softwarestand“ ein. Nach zwei Quartalen liegt dann die Zahl vor, die Sie in die Rechnungen unten einsetzen können.
Wie lassen sich ungeplante Maschinenstillstände reduzieren?
Der erste Schritt ist die lückenlose Erfassung der Stillstandsgründe; danach arbeitet eine Pareto-Analyse die häufigsten drei bis fünf zuerst ab. Gegen verschleißbedingte Stillstände helfen Total Productive Maintenance (TPM) und Predictive Maintenance, gegen rüstbedingte die Rüstzeitoptimierung (SMED). Für den softwarebedingten Anteil, den keiner dieser Ansätze erfasst, sind es Versionierung, automatisierte Tests vor dem Rollout und ein definierter Rückweg auf den letzten funktionierenden Stand.
Bei diesem Anteil zählt vor allem die Dauer eines Vorfalls. Ob eine Linie nach sechs Stunden oder nach zwanzig Minuten wieder läuft, hängt davon ab, ob es einen letzten bekannten guten Stand gibt. Die Kennzahl dafür heißt Mean Time to Recovery (MTTR), und genau diese Differenz rechnet Rechnung 1 durch.
Was hat Versionsverwaltung mit Predictive Maintenance zu tun?
Mehr, als man zunächst denkt. Ein Modell für Predictive Maintenance lernt aus Sensordaten, und diese Daten lassen sich nur deuten, wenn bekannt ist, welcher Software- und Parameterstand zu welchem Zeitpunkt auf der Anlage lief. Ändert jemand unbemerkt einen Grenzwert, sieht das Modell eine Anomalie, wo in Wahrheit nur ein neuer Stand eingespielt wurde. Versionierte Steuerungsstände liefern diesen Kontext. Deshalb lohnt es sich, sie vor dem Predictive-Maintenance-Projekt einzuführen und nicht danach.
Drei Kostenblöcke,
die jede OT-Organisation
ohnehin trägt.
DevOps spart nicht überall Geld, wo es gut klingt. Diese drei Blöcke tragen Sie aber heute schon, ob sie in einer Kostenstelle sichtbar sind oder nicht. Die Ausgangslage ist in den Werken, die wir kennen, fast immer dieselbe: Stände auf Netzlaufwerken, Rollouts von Hand, Tests erst beim Anlauf. Die Blöcke sind so abgegrenzt, dass kein Euro zweimal gezählt wird.
- /01
Ungeplanter Stillstand
Der teuerste Posten und der am schlechtesten gemessene.
Siemens beziffert eine Stunde ungeplanten Stillstand in großen Werken auf 36.000 USD in der Konsumgüterindustrie und 2,3 Mio. USD in der Automobilfertigung. Wie viel davon auf fehlerhafte Software-Stände zurückgeht, weiß kaum ein Werk, weil es dafür keine Kategorie gibt. Genau dieser Anteil lässt sich mit Versionierung und Rollback verkürzen.
- /02
Manuelle Rollouts
Jedes Update von Hand bindet die Leute, die die Produktion am Laufen halten.
Bei 60, 80 oder 200 Steuerungen wird daraus schnell eine Tagesfüllung. Die Stunden tauchen nirgends als Kosten auf, weil sie als normale Arbeit gelten. Bezahlt werden sie trotzdem, und in dieser Zeit bleibt alles andere liegen.
- /03
Spät entdeckte Fehler
Ein Fehler auf der Anlage kostet ein Vielfaches dessen, was er in der Pipeline gekostet hätte.
Die Zehnerregel aus dem Qualitätsmanagement fasst das als Faustregel: Mit jeder Phase, die ein Fehler unentdeckt weiterwandert, verzehnfachen sich ungefähr seine Kosten. Hier zählen nur die Fehler, die keinen Stillstand auslösen, sondern Nacharbeit, Sonderfahrten oder Sperrbestand. Der Posten ist der kleinste der drei, aber der am leichtesten zu übersehende.
Der ungeplante Stillstand:
was Rückrollbarkeit wert ist.
Was kostet ein Maschinenstillstand pro Stunde?
Eine Stunde Stillstand kostet vor allem den Deckungsbeitrag, den die Linie in dieser Stunde nicht erwirtschaftet, dazu das stehende Personal, die Fixkosten der Anlage sowie Anlauf- und Folgekosten danach. Siemens beziffert das für große Werke auf 36.000 USD pro Stunde in der Konsumgüterindustrie und 2,3 Mio. USD in der Automobilfertigung. Für eine mittelständische Linie setzen wir 15.000 € an und leiten den Wert unten her.
Stillstandskosten je Stunde = entgangener Deckungsbeitrag + stehendes Personal + Fixkosten der Anlage + Anlauf- und Folgekosten
Wie berechnet man die Stillstandskosten einer Linie?
Die Beispiel-Linie fertigt 400 Teile pro Stunde mit einem Deckungsbeitrag von 30 € je Teil, also dem Verkaufspreis abzüglich Material und anderer variabler Kosten. An ihr arbeiten 14 Personen. Sie ist ausgelastet, die verlorene Menge lässt sich also nicht nachholen. Nach einem Stillstand braucht sie eine Weile, bis die Qualität wieder stimmt, und verspätete Lieferungen gehen per Expressfracht raus. Posten für Posten sieht das so aus:
Zwei Dinge fallen an dieser Tabelle auf. Der Maschinenstundensatz aus der Kalkulation steckt nur in der Zeile „Fixkosten“ und macht keine zwei Prozent aus; wer Stillstandskosten mit dem Maschinenstundensatz rechnet, unterschätzt sie deshalb um ein Vielfaches. Und der größte Posten gilt nur, wenn die Linie ausgelastet ist. Lässt sich die Menge in einer freien Schicht nachholen, fällt der Deckungsbeitrag weg, und an seine Stelle treten die Kosten dieser Schicht. Beides zusammen zu zählen, wäre doppelt gerechnet. Setzen Sie für Ihr Werk die Variante ein, die ehrlich ist.
Für die Rechnung nehmen wir zwei softwarebedingte Stillstände pro Jahr an, die jeweils 4 Stunden dauern. Das ist kürzer als die Nacht an Linie 4, aber deutlich länger als der Durchschnitt aller Stillstände: Siemens zählt für große Werke 25 Vorfälle und 27 Stunden im Monat, also gut eine Stunde je Vorfall. Ein Softwarefehler, bei dem erst jemand den letzten guten Stand rekonstruieren muss, dauert erfahrungsgemäß länger als ein verklemmter Sensor.
Einsparung: 109.500 € pro Jahr. Ohne Versionierung sind es 2 × 4 h × 15.000 € = 120.000 €, mit Versionierung 0,7 × 1 h × 15.000 € = 10.500 €.
Zwei Annahmen tragen das Ergebnis. Die Dauer sinkt von vier Stunden auf eine, weil ein git revert mit anschließendem Download und Probelauf die nächtliche Rekonstruktion ersetzt. Die Zahl der Vorfälle sinkt um 65 %, weil Änderungen vor dem Rollout geprüft werden. Laut DORA-Report 2024 scheitern bei den leistungsstärksten Teams rund 5 % der Änderungen, bei den schwächsten rund 40 %. Das wären 87 % weniger; wir setzen bewusst weniger an.
Wie verwaltet man SPS-Programme mit Git?
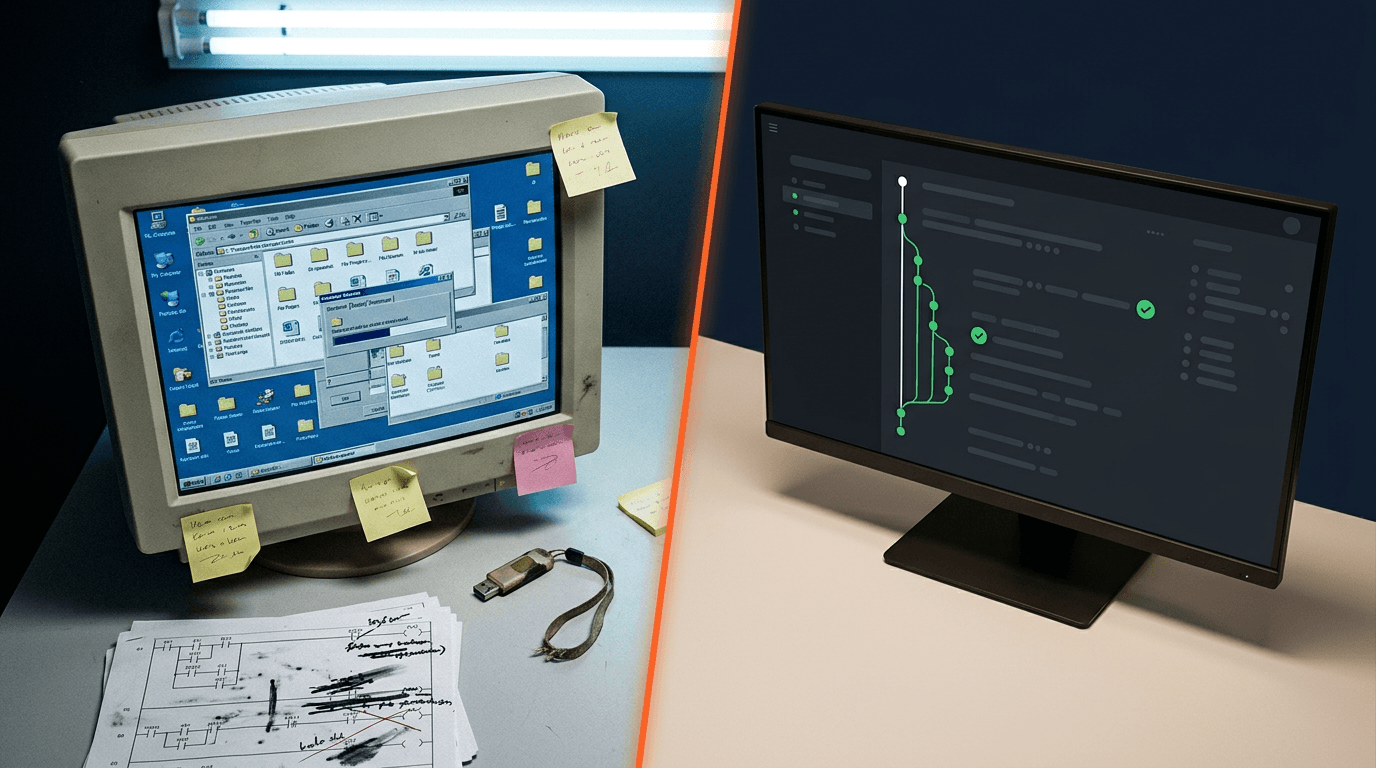
SPS-, Roboter- und SCADA-Stände kommen in dieselbe Versionsverwaltung wie jeder andere Code, also in Git auf GitLab oder GitHub, exportiert aus der jeweiligen Engineering-Umgebung. Siemens TIA Portal liefert über TIA Portal Openness und das Version-Control-Interface textbare Projektstände, CODESYS und Beckhoff TwinCAT ebenso. An die Stelle von Linie4_final_NEU_v3 tritt eine Historie, aus der hervorgeht, wer was wann geändert hat. Geht ein Update schief, rollt ein git revert auf den letzten funktionierenden Stand zurück.
 AI
Aus dieser Rückrollbarkeit kommen die drei eingesparten Stunden je Vorfall in der Tabelle oben. Wie das für SPS/PLC-Umgebungen praktisch aussieht, zeigt der Anwendungsfall Maschinenbau & SPS/PLC.
Der manuelle Rollout:
vom Tagewerk zum Knopfdruck.
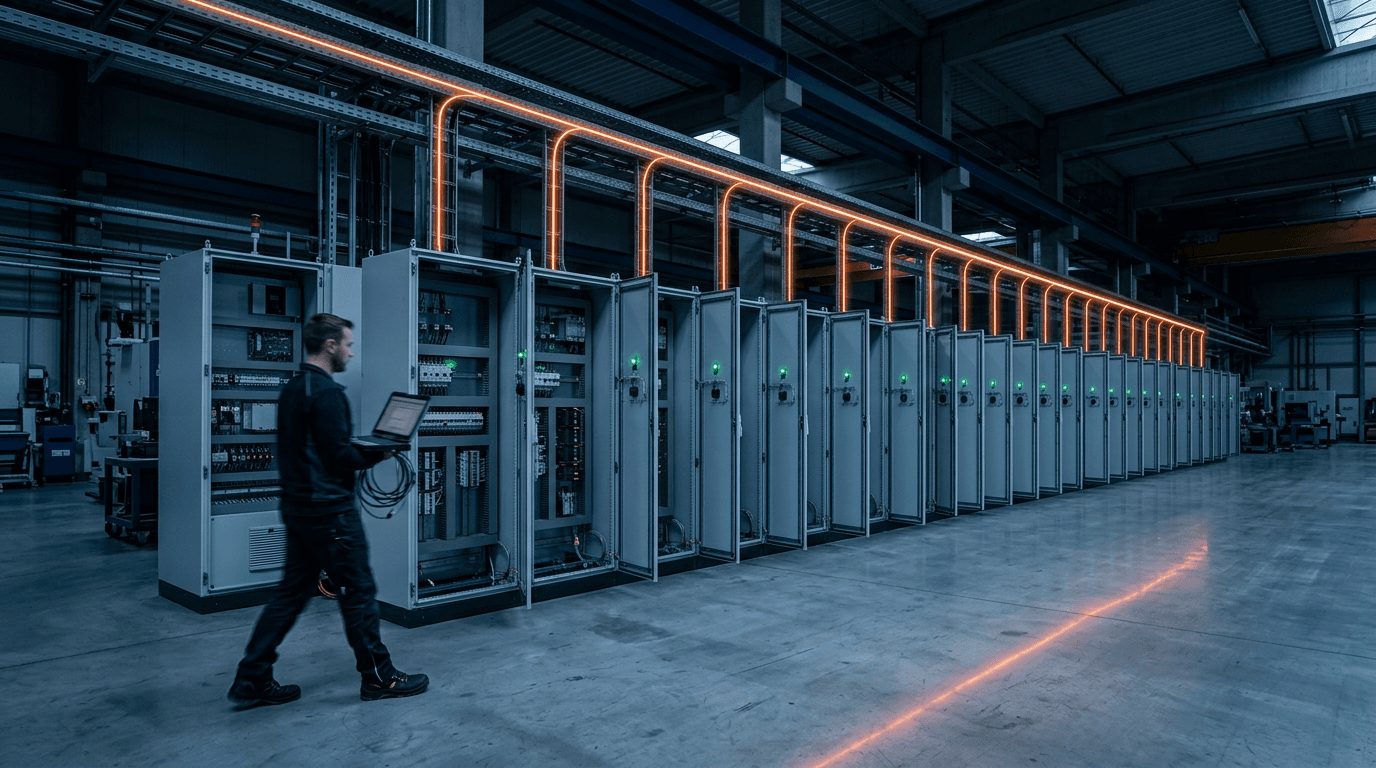
In dieser Rechnung steht keine Linie. Hier geht es um die Arbeitszeit der OT-Spezialisten. Das Beispielwerk hat 60 Knoten, also SPS, Edge-Gateways und SCADA-Stationen. Es spielt vier Update-Runden pro Jahr ein, jede Runde braucht 30 Minuten je Knoten mit Prüfung und Dokumentation, und eine Spezialistenstunde kostet vollkostet 85 €.
Einsparung: 9.350 € pro Jahr an Arbeitszeit, also 10.200 € minus 850 €. Mit der Pipeline bleiben pro Runde die Vorbereitung und die Freigabe, die Verteilung auf die 60 Knoten übernimmt sie selbst.
Der Betrag wirkt klein, und in die Summe geht er auch nur einmal ein. Wichtiger sind die 110 Stunden dahinter. Sie gehören den wenigen Leuten, die Ihre Anlagen wirklich kennen, und sie fließen künftig in Arbeit, die heute liegen bleibt: die Optimierung einer Linie, die Vorbereitung einer neuen, die Störung, die schon lange keiner angefasst hat. Was diese Arbeit wert ist, lässt sich nicht sauber beziffern, deshalb rechnen wir sie nicht noch einmal oben drauf.
Und der Aufwand wächst mit dem Werk. Bei 200 Knoten werden aus vier Arbeitstagen pro Runde zweieinhalb Wochen, und spätestens dann bleiben Updates liegen, die eigentlich eingespielt werden müssten.
 AI
Was ist GitOps für die SPS-Flotte, und was spart es?
Bei GitOps steht der gewünschte Stand jeder Anlage in Git, und eine CI/CD-Pipeline rollt ihn automatisiert und identisch auf alle Knoten aus. Kein Spezialist klickt sich mehr von Steuerung zu Steuerung. GitLab CI, Jenkins oder Argo CD übernehmen Verteilung, Freigabe und Protokoll. Am Ende einer Runde steht ein Soll-Ist-Abgleich für jeden Knoten statt der Aussage „hat geklappt, glaube ich“.
Wie sich eine solche Pipeline für OT-Umgebungen aufbauen lässt, beschreibt die Leistung CI/CD-Implementierung. Wie wiederkehrende Rollouts dauerhaft automatisiert bleiben, zeigt die DevOps-Automatisierung.
Der späte Fehler:
was Shift-Left verhindert.
Ein Team bringt 40 Steuerungsänderungen pro Jahr ins Werk. Ohne automatisierte Tests kommen 15 % davon mit einem Fehler auf der Anlage an, also sechs im Jahr. Fehler, die eine Linie anhalten, stecken schon in Rechnung 1. Hier zählen nur die drei, die Nacharbeit, eine Sonderfahrt oder gesperrte Ware auslösen, mit je 4.000 €.
Einsparung: 3.600 € pro Jahr. Wir nehmen an, dass Tests in der Pipeline 30 % der Fehler abfangen, bevor sie die Anlage erreichen. Das ist eine vorsichtige Modellannahme und keine Messung; der DORA-Abstand zwischen starken und schwachen Teams liegt deutlich höher. Mehr als der Betrag zählt, wo der Fehler auffällt. In der Pipeline kostet er einen roten Build und ein paar Minuten, auf der Anlage eine Schicht.
Was besagt die Zehnerregel der Fehlerkosten?
Die Zehnerregel, auch 1-10-100-Regel, ist eine Faustregel aus dem Qualitätsmanagement: Die Kosten eines Fehlers verzehnfachen sich ungefähr mit jeder Phase, die er unentdeckt weiterwandert, von der Entwicklung über die Fertigung bis zum Kunden. Sie beschreibt eine Größenordnung, keine Messung.
Vorsicht bei der Zahl, die in diesem Zusammenhang am häufigsten zitiert wird. Die angebliche Studie des IBM Systems Sciences Institute, nach der ein Fehler in Produktion 100-mal so viel kostet wie im Design, lässt sich auf keine veröffentlichte Untersuchung zurückführen, wie The Register 2021 nachgezeichnet hat. Die Richtung stimmt trotzdem, und für die Rechnung oben brauchen wir keinen Faktor, sondern nur den Unterschied zwischen einem roten Build und einer gesperrten Charge.
Drei Blöcke,
eine Bilanz.
Ein einziges mittelständisches Werk mit 60 Knoten, jede Einsparung genau einmal gezählt.
Dem stehen Tooling, Pipeline-Aufbau, Schulung und der erste Aufwand für die Versionierung gegenüber. Für einen ersten Wertstrom, also eine Anlage und eine Pipeline, liegt das nach unserer Erfahrung im niedrigen fünfstelligen Bereich. Rechnen wir großzügig mit 60.000 €, ist die Investition nach 60.000 ÷ 122.450 × 12 = knapp sechs Monaten zurückverdient. Die Einsparung wiederholt sich jedes Jahr, die Investition nicht.
Und wenn unsere Annahmen zu optimistisch sind? Rechnung 1 trägt fast 90 % der Summe, also lohnt sich dort die Gegenprobe. Hat Ihr Werk nur einen softwarebedingten Stillstand im Jahr statt zwei, sinkt die Einsparung auf 67.700 €, und die Amortisation verlängert sich auf knapp elf Monate. Kennen Sie Ihren Anteil nicht, ist die Kategorie „Softwarestand“ in der Störungserfassung der erste Schritt, noch vor jedem Projekt.
Alle Zahlen sind Beispielrechnungen. Ihre realen Werte hängen von Deckungsbeitrag, Knotenzahl, Stundensätzen und Vorfällen ab. Mit Ihren eigenen Werten rechnet der ROI-Rechner.
Welcher Kostenblock ist bei Ihnen der erste?
Die drei Rechnungen oben fallen in keinem Werk gleich aus. Welcher Block bei Ihnen zuerst Geld kostet, ist die eine Hälfte der Antwort. Die andere ist, wie Ihr Steuerungsstand heute abgelegt ist, denn daran hängt, welcher erste Schritt überhaupt trägt.
Wo verbrennt bei Ihnen im Moment das meiste Geld?
„Wir haben doch
noch nie eine Pipeline
gebraucht.“
Das ist der Einwand, den wir am häufigsten hören. Er stimmt sogar, solange niemand die Posten zusammenzählt, auf die sich die Kosten verteilen.
Die Nachtschicht, die als Pech verbucht wird. Die zwei Tage Rollout, die als normale Arbeit gelten. Der Spezialist, der in Rente geht und zwanzig Jahre Anlagenkenntnis mitnimmt, weil davon nie etwas in Git stand. Keiner dieser Posten hat eine eigene Zeile, und deshalb wirkt der Status quo billig.
Versionierung macht diese Kosten zuerst messbar und dann kleiner. Dieselbe Disziplin erfüllt nebenbei, was NIS-2 und der Cyber Resilience Act an Nachweisen verlangen: eine lückenlose Änderungshistorie und dokumentierte Freigaben. Fragt der Auditor nach dem Freigabenachweis für das letzte Steuerungsupdate, ist ein Git-Log eine Antwort. Ein Netzlaufwerk ist keine. Die Compliance kostet in diesem Fall kaum extra, sie fällt beim Versionieren mit ab.
Eine Anlage.
Eine eigene Zahl.
Für den Anfang braucht es kein Werksprojekt. Wählen Sie die Anlage, deren letzter Stillstand am meisten wehgetan hat, bringen Sie ihre Steuerungsstände in Git und führen Sie parallel die Kategorie „Softwarestand“ in der Störungserfassung ein. Nach einem Quartal haben Sie zwei Dinge, die Sie vorher nicht hatten: den letzten guten Stand dieser Anlage auf Knopfdruck und eine erste eigene Zahl für Rechnung 1.
Aus dieser Zahl wird ein Budgetantrag, wenn eine Baseline dazukommt. Die erheben Sie im Workshop Industrial DevOps in 90 Tagen, zusammen mit einem Pilot-Plan und einem KPI-Zielblatt, an dem sich am Tag 90 nachrechnen lässt, was die Änderung gebracht hat. Oft ist es ein unspektakulärer Moment, der im Haus die Meinung dreht: Das Update, für das früher ein Kollege zwei Tage durchs Werk lief, ist vor der Frühstückspause auf allen Anlagen.
Was Controller
wirklich fragen.
- Q.01
- Was bedeutet Maschinenstillstand?
- Ein Maschinenstillstand (englisch Downtime) ist jeder Zeitraum, in dem eine Produktionsanlage nicht produziert, obwohl sie laut Plan produzieren sollte. Unterschieden wird zwischen geplanten Stillständen (Wartung, Rüsten, Inspektion) und ungeplanten. Die ungeplanten sind die teuren, weil sie ohne Vorwarnung Ausbringung, Liefertermine und Spezialistenzeit kosten. Nach ISO 22400 zählen beide zu den Verfügbarkeitsverlusten der Gesamtanlageneffektivität (OEE).
- Q.02
- Was kann zu einem Maschinenstillstand führen?
- Die klassischen Ursachen sind Verschleiß, Materialmangel, Rüstvorgänge, Kurzstillstände und Bedienfehler. Eine weitere Klasse wird selten benannt, obwohl sie in jeder modernen Anlage steckt: der Software-Stand der Steuerung, also ein überschriebener Parameter, ein Update ohne Rückweg oder ein SPS-Projekt, dessen letzter funktionierender Stand nur auf einem Netzlaufwerk liegt. Gegen diese Ursache helfen weder Wartung noch Sensorik, sondern Versionierung und ein definierter Rückweg auf den letzten guten Stand.
- Q.03
- Wie nennt man Maschinenstillstand noch anders?
- Gebräuchliche Synonyme sind Downtime, Anlagenstillstand, Stillstandszeit und Ausfallzeit; in der Automobilfertigung spricht man beim Stillstand der Montagelinie vom Bandstillstand. Die ISO 22400 ordnet all diese Fälle den Verfügbarkeitsverlusten zu, der ersten der drei OEE-Komponenten neben Leistung und Qualität.
- Q.04
- Was kostet ein Maschinenstillstand pro Stunde in der Fertigung?
- Das hängt vor allem davon ab, wie viel Deckungsbeitrag die stehende Linie pro Stunde erwirtschaftet. Siemens beziffert die Kosten einer Stunde ungeplanten Stillstands in großen Werken auf 36.000 USD in der Konsumgüterindustrie und 2,3 Mio. USD in der Automobilfertigung (True Cost of Downtime 2024). Für eine mittelständische Linie rechnen wir in diesem Artikel mit 15.000 € pro Stunde und leiten den Wert Posten für Posten her: entgangener Deckungsbeitrag, stehendes Personal, Fixkosten der Anlage, Anlauf- und Folgekosten.
- Q.05
- Wie teuer ist ein Bandstillstand?
- In der Automobilfertigung kostet eine Stunde Bandstillstand laut Siemens True Cost of Downtime 2024 rund 2,3 Mio. USD, doppelt so viel wie 2019. Auf die Minute gerechnet sind das etwa 38.000 USD, mehr als 600 USD pro Sekunde. Der Grund sind Just-in-Time-Lieferketten: Steht ein Band, stehen nachgelagerte Werke und Zulieferer mit. Deshalb braucht in der Automobilindustrie jede Steuerungsänderung einen dokumentierten Rückweg.
- Q.06
- Wie berechnet man die Kosten eines Maschinenstillstands?
- Stillstandskosten je Stunde sind die Summe aus entgangenem Deckungsbeitrag (Ausbringung pro Stunde mal Deckungsbeitrag je Teil), den Kosten des stehenden Personals, den Fixkosten der Anlage sowie den Anlauf- und Folgekosten wie Ausschuss oder Expressfracht. Dieser Wert mal Stillstandsdauer ergibt die Kosten je Vorfall, mal Vorfallshäufigkeit die Jahressumme. Der Maschinenstundensatz allein reicht nicht, weil er nur die Kosten der Maschine abbildet und den verlorenen Umsatz nicht enthält.
- Q.07
- Wie berechnet man Maschinenstillstandszeiten?
- Die Stillstandsquote ist die Stillstandszeit geteilt durch die geplante Produktionszeit, meist als Prozentwert; ihr Gegenstück ist die Verfügbarkeit als erste OEE-Komponente. Für die Kostenseite multipliziert man die Stillstandsdauer mit den Stillstandskosten je Stunde. Softwarebedingte Stillstände werden am stärksten über die Dauer kürzer: Zurückrollen auf einen versionierten Stand dauert Minuten, Rekonstruieren Stunden.
- Q.08
- Wie lassen sich ungeplante Maschinenstillstände reduzieren?
- Zuerst werden die Stillstandsgründe lückenlos erfasst und per Pareto-Analyse die häufigsten abgearbeitet. Gegen verschleißbedingte Stillstände helfen Total Productive Maintenance und Predictive Maintenance, gegen rüstbedingte die Rüstzeitoptimierung (SMED). Für den softwarebedingten Anteil, den keiner dieser Ansätze erfasst, sind es Versionierung, automatisierte Tests vor dem Rollout und ein definierter Rückweg auf den letzten funktionierenden Stand.
- Q.09
- Was ist der Unterschied zwischen Instandhaltung und Reparatur?
- Instandhaltung ist der Oberbegriff und umfasst Wartung, Inspektion, Instandsetzung und Verbesserung; die Reparatur ist nur der instandsetzende Teil, also die Behebung eines bereits eingetretenen Schadens. Für die Stillstandsrechnung ist das wichtig, weil vorbeugende Instandhaltung geplante Stillstände erzeugt, während eine Reparatur fast immer auf einen ungeplanten folgt. Softwarebedingte Ausfälle passen in keine der beiden Kategorien: Ein falscher Steuerungsstand ist kein Schaden am Bauteil.
- Q.10
- Was zählt alles zu den Instandhaltungskosten?
- Zu den Instandhaltungskosten zählen Personal, Ersatzteile und Material, Fremdleistungen, Werkzeuge und Instandhaltungssysteme sowie die Ausfallkosten des Stillstands selbst. Der letzte Posten ist in vielen Werken der größte und zugleich der am schlechtesten erfasste, weil er in der Kostenstelle Produktion landet und nicht in der Instandhaltung. Wer Stillstandsgründe getrennt nach Mechanik, Material, Rüsten und Softwarestand erfasst, sieht nach zwei Quartalen, welcher Anteil überhaupt ein Instandhaltungsthema ist.
- Q.11
- Wo senkt Industrial DevOps konkret Kosten?
- An drei Stellen. Versionierung und Rollback verkürzen softwarebedingte Stillstände, CI/CD und GitOps ersetzen manuelle Rollouts auf jede einzelne Steuerung, und automatisierte Tests fangen Fehler in der Pipeline ab, bevor sie auf der Anlage Nacharbeit auslösen.
- Q.12
- Wann amortisiert sich Industrial DevOps?
- In der Beispielrechnung für ein Werk mit 60 Steuerungen und Edge-Knoten summieren sich die Einsparungen auf rund 122.000 € pro Jahr. Bei 60.000 € Erstinvestition für einen ersten Wertstrom amortisiert sich das Vorhaben in knapp sechs Monaten. Tritt nur halb so oft ein softwarebedingter Stillstand auf wie angenommen, sind es knapp elf Monate.
- Q.13
- Was besagt die Zehnerregel der Fehlerkosten?
- Die Zehnerregel, auch 1-10-100-Regel, ist eine Faustregel aus dem Qualitätsmanagement: Die Kosten eines Fehlers verzehnfachen sich ungefähr mit jeder Phase, die er unentdeckt weiterwandert, von der Entwicklung über die Fertigung bis zum Kunden. Sie beschreibt eine Größenordnung und keine Messung; auch die oft zitierte IBM-Zahl „1 zu 100“ lässt sich auf keine veröffentlichte Studie zurückführen. Für Steuerungssoftware heißt das: Ein Fehler, den die Pipeline findet, kostet Minuten, derselbe Fehler auf der Anlage eine Schicht.
- Q.14
- Warum tauchen diese Kosten in keiner Bilanz auf?
- Weil sie sich auf viele kleine Posten verteilen: die Nachtschicht, die als Pech gilt, die zwei Tage Rollout, die als normale Arbeit gelten, und das Spezialistenwissen, das nie in Git stand. Weil keiner dieser Posten eine eigene Zeile hat, wirkt der Status quo billig, bis man sie addiert.
Die Marktzahlen stammen aus den unten genannten Quellen. Alles, was das Beispielwerk beschreibt, also Deckungsbeitrag, Personal, Knotenzahl, Stundensätze, Vorfallshäufigkeiten, die Reduktionen um 65 % und 30 % sowie die Investition von 60.000 €, sind unsere Modellannahmen. Sie beschreiben eine Größenordnung und keine Messung in einem bestimmten Werk. USD-Werte sind nicht in Euro umgerechnet.
- Stillstandskosten. Siemens, The True Cost of Downtime 2024 (PDF): Eine Stunde Stillstand kostet in großen Werken 2,3 Mio. USD in der Automobilfertigung, doppelt so viel wie 2019, und 36.000 USD in der Konsumgüterindustrie. Große Werke haben im Schnitt 25 ungeplante Stillstände und 27 Stillstandsstunden im Monat. Die Fortune Global 500 verlieren dadurch 11 % ihres Umsatzes.
- Software-Delivery. DORA, Accelerate State of DevOps Report 2024: Die Change Failure Rate liegt bei den leistungsstärksten Teams um 5 %, bei den schwächsten um 40 %.
- Fehlerkosten. Die Zehnerregel ist eine Faustregel des Qualitätsmanagements ohne einzelne empirische Quelle. Zur nicht auffindbaren IBM-Studie „1 zu 100“: The Register, Juli 2021.
- Rechenweg. Rechnung 1: 2 × 4 h × 15.000 € gegen 0,7 × 1 h × 15.000 €. Rechnung 2: 120 h gegen 10 h zu je 85 €. Rechnung 3: 3 gegen 2,1 Vorfälle zu je 4.000 €. Summe 122.450 €. Gegenprobe mit einem Stillstand pro Jahr: 54.750 € + 9.350 € + 3.600 € = 67.700 €, Amortisation 10,6 Monate.
Ihre Zahlen.
Ihre drei Blöcke.
30 Minuten.
Wir rechnen Ihre drei Blöcke gemeinsam durch, mit Ihrem Deckungsbeitrag, Ihren Knoten und Ihren Stundensätzen, und zeigen, wo der erste Wertstrom am schnellsten zurückverdient ist. 30 Minuten, kostenlos, ohne Verpflichtung. Die Rechnung nehmen Sie mit, egal wie Sie sich danach entscheiden.
Was passiert bei Ihnen mit dieser Rechnung?
Sagen Sie uns mit einem Klick, was aus diesen Zahlen bei Ihnen wird. Passend dazu bekommen Sie einen konkreten nächsten Schritt. Ganz ohne Formular.
Verwandte Artikel
DORA Metrics: DevOps-Performance messen
Die Kennzahlen hinter den Rechnungen: Lead Time, Change Failure Rate, MTTR.
Value Stream Mapping: Engpässe sichtbar machen
Wo im Wertstrom die Kosten liegen und wie Sie sie messbar machen.
Smart Factory mit SCADA & CI/CD
Der Rollout-Block in der Praxis: SCADA versionieren statt klicken.
Erstgespräch.
Kostenlos.
90 Tage zum Ergebnis.
Wir klären gemeinsam, wie Sie in 90 Tagen die ersten messbaren Industrial-DevOps-Erfolge erzielen.
Industrie · Automotive · Finance