Corporate LLMs
in Industrial DevOps:
Vorteile, Hürden, Praxis.
Ihre Entwickler kennen ChatGPT. Ihr Sicherheitskonzept kennt es auch und verbietet es. Ein Corporate LLM löst diesen Widerspruch, indem es das Modell dorthin holt, wo die Daten ohnehin liegen: ins eigene Netz.
 AI
Andreas Schönfeld
Geschäftsführer & DevOps-Berater, Comquent GmbH
DevOps, CI/CD und Industrial Automation seit 2006.
Stand: 2. Oktober 2026 · Modell- und Toolnamen als Beispiele, ohne Versionsstand · Regulatorik einordnend, keine Rechtsberatung
Ein Corporate LLM ist ein Sprachmodell, das ein Unternehmen auf eigener Infrastruktur betreibt und über Retrieval-Augmented Generation (RAG) an das eigene Wissen anbindet. RAG legt jeder Anfrage passende Auszüge aus internen Quellen bei. So wird generative KI dort nutzbar, wo Cloud-Dienste ausscheiden, weil Quellcode, SPS-Programme und Anlagendokumentation das Haus nicht verlassen dürfen. Den Nutzen bringen die Integration in die CI/CD-Kette und der Zugang zum eigenen Wissen, das Modell selbst ist austauschbar. Der Einstieg ist kleiner, als die meisten erwarten: ein Pilot auf kompakter Hardware, der nach sechs Wochen eine Entscheidung erlaubt.
Ist ein Corporate LLM bei Ihnen gerade ein Thema?
Wir fragen kurz, wie dringend das Thema bei Ihnen gerade ist. Je nach Antwort zeigen wir Ihnen direkt den passenden nächsten Schritt — ganz ohne Formular.
Was ist ein
Corporate LLM?
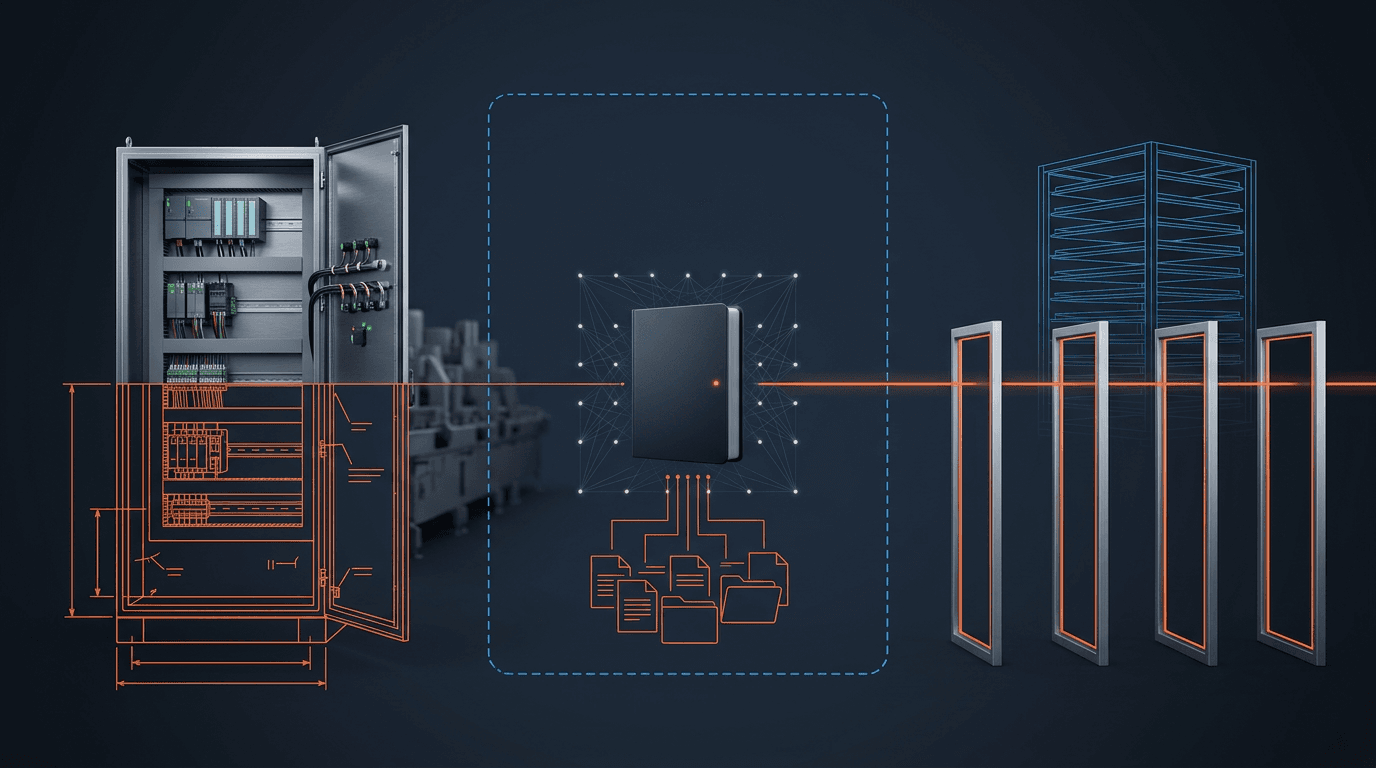
Ein Corporate LLM ist ein unternehmenseigenes, lokal betriebenes Sprachmodell mit Anbindung an internes Wissen. Die Definition hat drei Teile, und jeder trägt: eigene Infrastruktur, offenes Modell, RAG statt Training.
Der Begriff wird inzwischen auch für EU-gehostete KI-Plattformen verwendet, die fremde Modelle über eine eigene Oberfläche anbieten. Die Abgrenzung ist einfach: Läuft die Inferenz auf Hardware, die Sie kontrollieren? Wenn nein, haben Sie einen Enterprise-Tarif mit gutem Vertrag, Ihre Daten schützt also ein Vertrag. Bei einem Corporate LLM schützt sie die Architektur.
Der dritte Teil räumt mit dem häufigsten Missverständnis auf: Niemand trainiert ein eigenes Modell. Das wäre teuer, langsam und nach dem nächsten Modell-Release veraltet. Stattdessen bleibt das offene Basismodell unverändert, und ein RAG-System legt vor jede Anfrage die passenden Auszüge aus Ihren Dokumenten, Pipelines und Tickets in den Kontext und nennt die Quelle. Das Wissen liegt in einer Vektordatenbank, die sich täglich aktualisieren lässt. Das Modell können Sie austauschen, ohne dass dabei Wissen verloren geht.
 AI
| Kriterium | Enterprise-Tarif (Cloud) | Corporate LLM |
|---|---|---|
| Wo läuft die Inferenz | Rechenzentrum des Anbieters | eigene Hardware, eigenes Netzsegment |
| Was schützt die Daten | Vertrag: AVV, Zero-Data-Retention-Klausel, Region | Architektur: die Daten verlassen das Haus nicht |
| Kennt das Modell Ihr Unternehmen | nein, nur was im Prompt steht | ja, über RAG auf Doku, Pipelines und Tickets |
| Air-Gap-Betrieb | nein | ja, mit signiertem Update-Transfer |
| Kostenmodell | pro Token, skaliert mit der Nutzung | Hardware + Betrieb, planbar ab mittlerer Nutzerzahl |
Warum ist Industrial DevOps
ein Sonderfall?
Industrial DevOps ist für LLMs ein Sonderfall, weil vier Bedingungen zusammentreffen, die in der reinen IT einzeln schon selten sind: abgeschottete Netzsegmente, Lebenszyklen von 15 Jahren und mehr, gemischte Toolchains und Regulierung mit Nachweispflicht. Ein Cloud-Modell scheitert an der ersten Bedingung; die anderen drei entscheiden, ob ein lokales Modell etwas taugt.
Die IT/OT-Konvergenz bringt Build-Server und Steuerungen in dieselbe Lieferkette, aber nicht ins selbe Netz. Das Zonen-und-Conduits-Modell der IEC 62443 trennt bewusst; ein KI-Dienst, der nach außen telefoniert, passt in kein Conduit. Wer hier ein Modell einsetzen will, muss es in die Zone bringen oder darauf verzichten.
Dazu die Lebenszyklen: Eine Anlage aus 2012 läuft 2032 noch, ihre Dokumentation stammt aus drei Tool-Generationen, und der Entwickler, der sie schrieb, ist in Rente. Ein öffentliches Modell hat diese Dokumentation nie gesehen und wird sie auch nie sehen dürfen. Die Toolchain ist gemischt: Structured Text und Ladder nach IEC 61131-3 neben C/C++ für Embedded, Python für Testautomatisierung, Java und Groovy in den Pipelines. Und über allem liegt Regulierung. Sie will wissen, wer was wann freigegeben hat, und das müssen Sie nachweisen können.
Strategisch ist das die Stufe, die wir Intelligisierung nennen: nach Digitalisierung und Automatisierung arbeiten Systeme kontextbewusst. Ein Corporate LLM ist der Baustein, der diese Stufe in die abgeschottete Zone bringt, vorausgesetzt, Versionierung und Automatisierung stehen schon. Ohne Pipeline gibt es nichts, in das sich ein Modell integrieren ließe.
 AI
Welche Vorteile hat
ein Corporate LLM?
Der größte Vorteil eines Corporate LLM ist, dass es überhaupt eingesetzt werden darf. Die Modellqualität kommt erst danach. Die ersten vier Punkte unten antworten auf die vier Bedingungen aus Abschnitt 02. Datenhoheit und Air-Gap-Fähigkeit lösen das abgeschottete Netz, der Zugang zum eigenen Wissen die langen Lebenszyklen und die gemischte Toolchain, die Nachweisbarkeit die Regulierung. Die beiden letzten Punkte, Schatten-KI und Kostenkontrolle, kommen aus dem Betrieb.
Wie es ohne ein solches Werkzeug aussieht, zeigt meist schon das erste Gespräch mit dem Team. Die Linie produzierte Ausschuss, der Fehler steckte irgendwo im Structured Text, und öffentliche KI-Dienste waren verboten, ohne dass es eine Alternative gab. Also hat der Inbetriebnehmer den Fehlerblock in sein privates Chat-Konto kopiert. Das Programm einer Linie liegt jetzt irgendwo, wo es niemand mehr zurückholt. Der Kollege hätte ein erlaubtes Werkzeug genommen, wenn es eines gegeben hätte.
- /01
Datenhoheit und IP-Schutz
→ Abgeschottetes Netz
Quellcode, SPS-Programme, Rezepturen und Anlagendokumentation verlassen das Haus nicht, weil die Architektur es nicht zulässt. Kein Vertrag muss das versprechen. In vielen Industrieumgebungen ist das die Bedingung, ohne die über KI gar nicht erst gesprochen wird. - /02
Air-Gap-Fähigkeit
→ Abgeschottetes Netz
Vollständiger Offline-Betrieb in der abgeschotteten Zone. Modell-Updates kommen über kontrollierte, signierte Transferprozesse hinein, auf demselben Weg, den Betriebssystem-Patches in einem Air-Gap-CI/CD-Setup heute schon nehmen. Für die OT ist daran nur der Inhalt des Pakets neu. - /03
Zugang zum eigenen Wissen
→ Lange Lebenszyklen · Gemischte Toolchains
Über RAG antwortet das Modell auf Basis interner Handbücher, Pipelines und Ticket-Historie und nennt dabei die Quelle. Ein öffentliches Modell weiß nicht, dass Ihre Linie 3 einen Sonderfall im Rezeptur-Handling hat. Dieses Wissen macht den Unterschied, die Modellgröße kaum. - /04
Compliance und Nachweisbarkeit
→ Nachweispflicht
Der Betrieb im eigenen Verantwortungsbereich erleichtert die Einordnung unter NIS2, Cyber Resilience Act, IEC 62443 und EU AI Act. Interne Assistenzsysteme fallen dort in der Regel nicht unter Hochrisiko; Transparenz- und Dokumentationspflichten bleiben, und Sie belegen sie mit eigenen Protokollen statt mit Zusagen eines Anbieters. - /05
Schatten-KI beenden, statt sie zu verbieten
→ Aus dem Betrieb
Schatten-KI, englisch Shadow AI, ist die dienstliche Nutzung privater KI-Konten vorbei an IT-Freigabe und Datenschutz. Nach der Bitkom-Befragung vom Oktober 2025 kennen 25 Prozent der Unternehmen solche Fälle und weitere 17 Prozent vermuten sie, während erst 23 Prozent Regeln dafür aufgestellt haben. Ein offizielles, erlaubtes Werkzeug beendet das wirksamer als jedes Verbot. Verbote erzeugen Umwege; ein Werkzeug, das auf die eigene Doku antwortet, erzeugt Gewohnheit. - /06
Anbieterunabhängigkeit und Kostenkontrolle
→ Aus dem Betrieb
Offene Modellfamilien sind austauschbar, die Kosten folgen der Hardware statt der Token-Zahl. Ehrlich eingeordnet: Bei einer Handvoll Nutzer ist die Cloud günstiger. Der Business Case entsteht über Datenhoheit und über Skaleneffekte, wenn ganze Teams und Pipelines das Modell nutzen.
Was verlangt ein Corporate LLM
von Ihnen?
Die größte Hürde bei einem Corporate LLM liegt selten im Modell. Sie liegt in der Wissensbasis dahinter und im Betrieb drumherum. Schlechte Daten erzeugen schlechte Antworten, und eine Plattform ohne Eigentümer verfällt. Dazu kommen neue Angriffsflächen, die ein klassisches Sicherheitskonzept noch nicht kennt. Ob ein Team die Vorteile aus Abschnitt 03 tatsächlich nutzt, entscheidet sich an den sechs Punkten hier.
Im Audit fragt niemand, welches Modell Sie nutzen. Gefragt wird, welche Dokumente das System gesehen hat, wer sie sehen durfte und wie Sie nachweisen, dass die Antwort an den Techniker keine Inhalte aus dem Ordner der Geschäftsführung enthielt. Wer darauf erst nach dem Piloten eine Antwort sucht, baut die Berechtigungsschicht zweimal.
- /01
Was lokale Modelle heute tragen und was nicht
Lokale Modelle erreichen nicht in jeder Disziplin das Niveau der größten Cloud-Modelle. Es hängt am Aufgabenzuschnitt. Logs zusammenfassen, Jenkinsfiles erklären, in der eigenen Doku suchen, das tragen mittelgroße offene Modelle gut. Freie Architekturentscheidungen aus dem Nichts eher nicht. - /02
Halluzinationen und Freigabeprinzip
Antworten mit Konsequenz brauchen Quellenbezug und menschliche Prüfung. Alles, was Richtung Produktion wirkt, bleibt hinter einer Freigabe. Der Assistent schlägt vor, der Mensch merged. Diese Regel gilt am ersten Tag und am dreihundertsten. - /03
Datenqualität als häufigster Engpass
Schlecht gepflegte Wissensquellen erzeugen schlechte Antworten. Das Wiki, das seit Jahren niemand angefasst hat, und die drei widersprüchlichen Versionen der Inbetriebnahme-Anleitung sind der übliche Ausgangspunkt. Die Pflege der Wissensbasis ist Daueraufwand, kein Projektschritt. - /04
Betriebsaufwand und Kompetenz
GPU-Betrieb, Modell-Lifecycle, Evaluierung neuer Versionen: Ohne ein Team, das die Plattform verantwortet, verfällt sie. Wer schon einen Jenkins ohne Eigentümer erlebt hat, kennt den Verlauf. - /05
Prompt Injection über die eigene Wissensbasis
Prompt Injection über eingebundene Dokumente ist real. Ein präpariertes PDF in der Wissensbasis kann das Modell anweisen, Inhalte preiszugeben. RAG-Quellen sind als nicht vertrauenswürdige Eingaben zu behandeln, Berechtigungen bis auf Treffer-Ebene durchzusetzen. Die OWASP Top 10 für LLM-Anwendungen führen das Thema nicht ohne Grund an erster Stelle. - /06
Betriebsrat und Mitbestimmung vor dem ersten Prompt
Die Protokollierung von Anfragen ist in Deutschland mit Datenschutz und Betriebsrat abzustimmen, bevor der erste Nutzer einen Prompt abschickt. Eine Betriebsvereinbarung zur KI-Nutzung klärt, was protokolliert wird und wer die Protokolle sieht. Schulung und klare Nutzungsregeln gehören zur Einführung. Sonst entscheidet jeder selbst, was er dem Modell anvertraut.
Wo hilft ein Corporate LLM
in der Praxis?
Ein Corporate LLM trägt in Industrial DevOps an vier Stellen: bei der Log-Triage nach fehlgeschlagenen Builds, als Pipeline-Assistenz für Jenkinsfiles und SPS-Build-Automatisierung, als befragbare Wissensbasis über Handbücher und Altsystem-Doku und beim Entwerfen von Release Notes, Testberichten und Audit-Unterlagen. Alle vier haben einen klaren Trigger, beziehen sich auf Quellen und lassen einen Menschen freigeben. Die Beispiele stammen aus Projekten dieser Art, ohne Kundennamen und ohne erfundene Prozentwerte.
Log-Triage in Jenkins
- Ausgangssituation
- Nächtliche Builds und Testsuiten erzeugen Logmengen, die morgens niemand liest. Der rote Balken ist bekannt, die Ursache steht irgendwo in 40.000 Zeilen.
- Was das Corporate LLM tut
- Als automatischer Schritt nach fehlgeschlagenem Build fasst das Modell das Fehlerbild zusammen, gruppiert wiederkehrende Muster und sucht per RAG nach ähnlichen früheren Vorfällen in Ticket-Historie und alten Build-Logs. Technisch stecken dahinter eine Vektordatenbank (z. B. ChromaDB) und ein lokaler Inferenz-Server (z. B. Ollama oder vLLM), die direkt aus der Pipeline aufgerufen werden.
- Ergebnis
- Eine Meldung ans Team mit Hypothese, betroffenen Modulen und dem Verweis auf das Ticket von vor acht Monaten, das dasselbe Symptom beschrieb. Die Fehlersuche beginnt bei der Hypothese statt bei Zeile 1.
Pipeline-Assistenz
- Ausgangssituation
- Jenkinsfiles, Groovy Shared Libraries und JCasC-Konfigurationen sind über Jahre gewachsen. Ein Teil stammt von Kollegen, die nicht mehr im Haus sind; die Migration von Freestyle-Jobs zu deklarativen Pipelines wartet seit zwei Releases.
- Was das Corporate LLM tut
- Das Modell erklärt bestehende Pipelines und erzeugt neue nach Hausstandard, weil dieser Standard per RAG in der Wissensbasis liegt. Es hilft auch bei Migrationen, etwa von Freestyle zu Declarative oder von ClearCase zu Git. Dasselbe gilt für die Build-Automatisierung von SPS-Stacks wie TwinCAT, TIA Portal, CODESYS oder Rockwell, deren Kommandozeilen-Werkzeuge sich in eine Shared Library kapseln lassen.
- Ergebnis
- Pipeline-Änderungen folgen dem Hausstandard und nicht mehr dem Stil des jeweiligen Autors. Das Review kann sich auf die Logik konzentrieren, weil die Syntax stimmt.
Befragbare Wissensbasis
- Ausgangssituation
- Maschinenhandbücher, interne Wikis, Normauszüge und die Dokumentation des Altsystems liegen auf einem Netzlaufwerk. Wer etwas sucht, fragt den Kollegen, der es weiß, solange er noch im Haus ist.
- Was das Corporate LLM tut
- Per RAG werden die Quellen durchsuchbar; das Modell antwortet mit Quellenangabe und übernimmt die bestehenden Zugriffsrechte: Wer das Dokument nicht öffnen darf, bekommt auch keine Antwort daraus.
- Ergebnis
- Die Antwort kommt in Minuten, ohne Rückfragen über drei Abteilungen. Nebenbei bleibt das Wissen erhalten, wenn Kollegen in Rente gehen, und das Onboarding hängt nicht mehr davon ab, wer gerade Zeit hat.
Dokumentations-Entwürfe
- Ausgangssituation
- Release Notes, Testberichte und die Begleitdokumentation zur SBOM entstehen vor jedem Audit unter Zeitdruck. Jemand sucht sie von Hand aus Commits, Testergebnissen und Ticket-Kommentaren zusammen.
- Was das Corporate LLM tut
- Das Modell erzeugt den Entwurf aus den Artefakten der Pipeline: Commit-Historie, Testergebnisse, SBOM. Ein Mensch prüft, ergänzt und gibt frei. Die Verantwortung bleibt beim Team.
- Ergebnis
- Die Audit-Vorbereitung geht schneller, ohne dass jemand Verantwortung abgibt. Der Prüfer bekommt vollständige Dokumente, das Team die Stunden zurück.
 AI
Am schnellsten sichtbar wird das erste Beispiel, denn wer bisher jeden Morgen zuerst das Log des Nightly durchsucht hat, liest jetzt drei Zeilen und öffnet das verlinkte Ticket. Wenige Wochen später fragt das Team, ob dieselbe Meldung auch nach den Integrationstests kommen kann.
post {
  failure {
    script {
      // Letzte 400 Zeilen reichen dem Modell — der Rest ist Rauschen.
      sh 'tail -n 400 "${JENKINS_HOME}/jobs/${JOB_NAME}/builds/${BUILD_NUMBER}/log" > build-tail.log'

      // Lokaler RAG-Dienst im eigenen Netzsegment: Vektordatenbank (ChromaDB)
      // + Inferenz-Server (Ollama/vLLM). Kein Byte verlässt das Haus.
      def triage = sh(
        returnStdout: true,
        script: '''
          curl -s http://llm-gateway.build.internal/triage \
            -H "Authorization: Bearer $(cat /run/secrets/llm-token)" \
            -F "job=${JOB_NAME}" -F "build=${BUILD_NUMBER}" \
            -F "log=@build-tail.log"
        '''
      )
      def r = readJSON text: triage

      // Nur melden, nie handeln: die Entscheidung bleibt beim Team.
      slackSend channel: '#ci-linie3', message: """
        Build ${JOB_NAME} #${BUILD_NUMBER} rot — Triage:
        ${r.summary}
        Ähnliche Vorfälle: ${r.similar.collect { "${it.ticket} (${it.date})" }.join(', ')}
        Quellen: ${r.sources.join(', ')}
      """
    }
  }
}Der Schritt läuft im post-Block und meldet nur. Er startet keinen Retry, ändert keine Konfiguration, deployt nichts. Das Gateway sitzt im selben Netzsegment wie der Build-Server, der Token liegt im Secret-Store, und die Antwort nennt ihre Quellen, damit sie sich prüfen lässt.
Die Hardware ist
kleiner als gedacht.
 AI
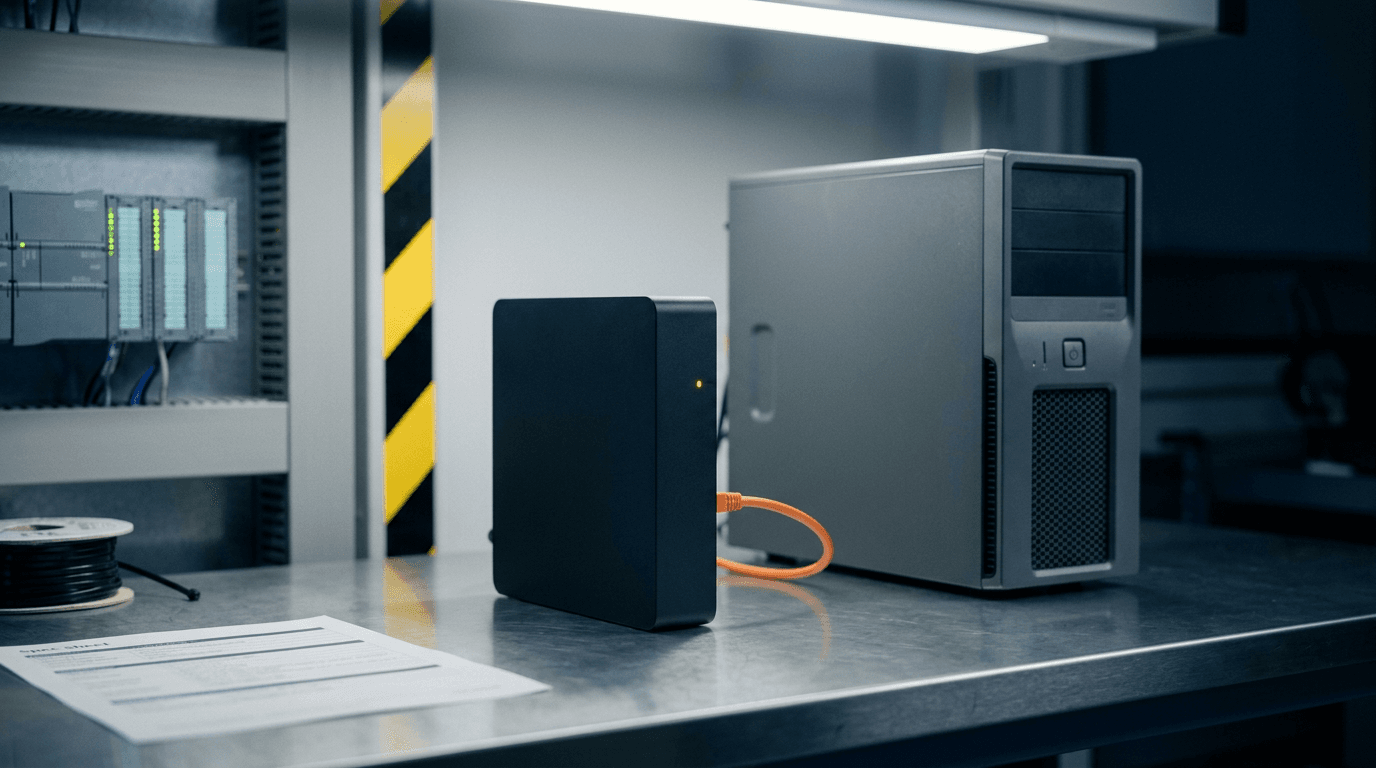
Für Pilotprojekte und Team-Installationen genügen kompakte Systeme mit 64 bis 128 GB Unified Memory, etwa der Geräteklasse Minisforum AI X1 Pro oder GMKtec EVO-X2. Das Gehäuse passt neben den Build-Server, und eine Abteilung kann es aus dem eigenen Budget bezahlen. Darauf laufen mittelgroße offene Modelle mit RAG für eine Gruppe von fünf bis zehn Nutzern, ohne dass jemand auf Antworten wartet.
Wächst die Nutzung, wächst die Hardware: ein GPU-Server im Rechenzentrum, dieselbe Software, dieselbe Vektordatenbank, dieselben Berechtigungen. Die Architektur bleibt dieselbe. Wer den Piloten richtig schneidet, wirft deshalb später nichts weg.
Corporate LLM, EU-Cloud oder erst einmal evaluieren?
Ob Sie ein eigenes Modell betreiben sollten, hängt kaum an der Modellqualität. Es hängt an zwei Fragen: Was darf Ihr Netz verlassen, und wo soll das Modell arbeiten? Zwei Klicks, und Sie sehen das Betriebsmodell, das durch Ihr Sicherheitsreview kommt.
Was darf Ihr Netz verlassen?
Wie führen Sie ein
Corporate LLM ein?
Ein Corporate LLM führen Sie in drei Phasen ein. Zuerst klären Sie Anwendungsfall, Mitbestimmung und Messkriterien, dann bauen Sie es auf einem Gerät auf und testen es mit fünf bis zehn Nutzern, zuletzt entscheiden Sie und rollen es mit Betriebsvereinbarung, Schulung und einem verantwortlichen Team aus. Vom Start des Piloten bis zur Entscheidung vergehen sechs Wochen. Wie lange die Vorbereitung dauert, hängt vor allem daran, wie früh Betriebsrat und Datenschutz am Tisch sitzen.
Am Modell scheitert ein Pilot selten. Er scheitert an der Wissensquelle, die seit Jahren niemand gepflegt hat, oder an der Frage nach den Protokollen, die zwei Wochen vor dem Rollout zum ersten Mal gestellt wird. Die Reihenfolge unten holt beides nach vorn.
Phase 1: Vorbereitungvor dem Start
Einen Anwendungsfall wählen, nicht drei
Log-Triage nach fehlgeschlagenem Build ist der dankbarste Einstieg: klarer Trigger, klarer Output, kein Weg in die Produktion. Wer mit der Wissensbasis beginnt, startet mit dem Datenqualitäts-Problem statt mit dem Modell.
Betriebsrat, Datenschutz und IT-Sicherheit früh einbinden
Ein Corporate LLM, das Anfragen einzelnen Nutzern zuordnen kann, fällt in aller Regel unter § 87 Abs. 1 Nr. 6 BetrVG, der Betriebsrat bestimmt also mit. Das Arbeitsgericht Hamburg hat die Mitbestimmung im Januar 2024 für ChatGPT über private Konten verneint (24 BVGa 1/24), weil der Arbeitgeber dort keine Nutzungsdaten sieht. Beim eigenen System sieht er sie. Klären Sie deshalb vor dem Piloten, was protokolliert wird und wer die Protokolle sieht. Der Datenschutz prüft parallel, ob eine Datenschutz-Folgenabschätzung nötig ist, und die Informationssicherheit legt das Netzsegment fest.
Messkriterien vor dem ersten Prompt festlegen
Für die Log-Triage sind das die Zeit bis zur Ursachenhypothese, der Anteil korrekt gruppierter Fehlerbilder und die Treffer auf ähnliche frühere Vorfälle. Halten Sie dafür eine Baseline aus den letzten Wochen fest, sonst bleibt der Nutzen Ansichtssache.
Phase 2: Aufbau und Pilotsechs Wochen
Kompakte Hardware, eigenes Netzsegment
Ein System mit 64 bis 128 GB Unified Memory neben dem Build-Server, Inferenz-Server und Vektordatenbank darauf, Zugriff nur aus der Pipeline und vom Team. Der Weg zum GPU-Server im Rechenzentrum ist später derselbe, nur größer.
Das Modell an eigenen Fällen auswählen
Nehmen Sie zwei oder drei offene Modelle in die engere Wahl und lassen Sie jedes ein paar Dutzend echte Fehlerbilder aus Ihrer Ticket-Historie zusammenfassen. Öffentliche Benchmarks sagen wenig darüber, wie ein Modell mit Ihren Logs zurechtkommt. Lesen Sie dabei die Lizenz, denn manche Modelle stehen unter Apache 2.0, andere unter eigenen Community-Lizenzen mit Nutzungsbedingungen. Es gewinnt das Modell, dessen Zusammenfassungen das Team am häufigsten ohne Nacharbeit übernimmt, auch wenn es nicht das größte ist.
Die Wissensbasis klein anfangen und die Rechte mitnehmen
Indexieren Sie für das RAG-System nur, was der Anwendungsfall braucht, für die Log-Triage also Ticket-Historie und alte Build-Logs, nicht das ganze Netzlaufwerk. Jeder Abschnitt in der Vektordatenbank trägt die Zugriffsrechte seines Quelldokuments, und die Suche filtert danach, bevor das Modell den Text sieht. Behandeln Sie jedes eingebundene Dokument als nicht vertrauenswürdige Eingabe, denn über ein präpariertes PDF kommt Prompt Injection ins System.
An die Pipeline anschließen, die nur meldet
Ein Gateway im selben Netzsegment nimmt Anfragen aus dem post-Block der Pipeline und vom Pilotteam an, mit einem Token aus dem Secret-Store. Es protokolliert so, wie es in Schritt 02 vereinbart wurde, und jede Antwort trägt ihre Quellen. Der Schritt meldet nur, er startet keinen Retry und deployt nichts. Wie das in einem Jenkinsfile aussieht, zeigt der Auszug in Abschnitt 05.
Fünf bis zehn Nutzer, die den Schmerz kennen
Das Pipeline-Team, nicht die ganze Abteilung. Wer die Logs heute liest, erkennt in der ersten Woche, ob die Zusammenfassungen tragen, und sagt es auch. Eine halbe Stunde pro Woche reicht, um zu sammeln, was getragen hat und was nicht.
Phase 3: Entscheidung und Einführungab Woche sieben
Nach sechs Wochen entscheiden, nicht nach sechs Monaten
Legen Sie die Messwerte neben die Baseline aus Schritt 03. Sind die Kriterien erfüllt, folgt der Rollout. Sind sie es nicht, korrigieren Sie zuerst Aufgabenzuschnitt oder Wissensquelle, bevor jemand ein größeres Modell oder einen GPU-Server beschafft.
Kriterien erfüllt: weiter mit Schritt 10.
Nicht erfüllt: zurück zu Schritt 05 und 06, dann erneut messen.
Betriebsvereinbarung und Schulung vor dem Rollout
Bevor weitere Teams dazukommen, regelt eine Betriebsvereinbarung, was protokolliert wird, wer die Protokolle sieht und wie lange sie aufbewahrt werden. Dazu gehört eine Schulung, die erklärt, welche Daten in welches Werkzeug dürfen und warum Antworten geprüft werden. Art. 4 der KI-Verordnung verlangt von Betreibern seit Februar 2025 Maßnahmen zur KI-Kompetenz ihres Personals. Der KI-Omnibus hat diese Pflicht im Juli 2026 abgeschwächt, gestrichen hat er sie nicht.
Einen Eigentümer benennen, dann ausbauen
Die Plattform braucht ein Team, das Modell-Updates gegen die Testfälle aus Schritt 05 prüft, die Wissensbasis pflegt und die Messkriterien weiter erhebt. Danach kommt der zweite Anwendungsfall dazu, etwa die Pipeline-Assistenz oder die Wissensbasis über Handbücher und Altsystem-Doku. Die Hardware wächst erst, wenn die Nutzung es verlangt.
Das Modell ist
der kleinste Teil.
Ein Corporate LLM macht generative KI dort nutzbar, wo Cloud-Dienste ausscheiden. Das ist die Eintrittskarte, mehr nicht. Ob daraus ein Werkzeug wird, entscheidet sich an der Integration in die CI/CD-Kette und am Zugang zum eigenen Wissen. Und an der Disziplin, alles, was Folgen für die Produktion hat, hinter einer menschlichen Freigabe zu lassen.
Datenqualität, Betrieb, neue Angriffsflächen und Mitbestimmung lassen sich in einem Piloten prüfen, bevor größere Hardware beschafft wird. Dafür reichen ein Anwendungsfall, fünf Nutzer, ein Gerät neben dem Build-Server und sechs Wochen.
Wenn Sie wissen wollen, welcher Anwendungsfall bei Ihnen der erste sein sollte, sprechen wir 30 Minuten darüber, mit Blick auf Ihre Pipelines und Ihr Netz. Die Vertiefung zu KI im DevOps-Betrieb, von Tool Management bis Self-Healing, finden Sie im Artikel AIOps in der Industrie.
Comquent GmbH mit Sitz in Puchheim bei München berät seit 2006 Industrieunternehmen in Jenkins, CI/CD-Automatisierung und Industrial DevOps, seit einiger Zeit auch beim Aufbau lokaler LLM-Deployments für abgeschottete OT-Umgebungen. Wer die Jenkins-Seite des Themas im eigenen Team verankern will, findet den passenden Einstieg im Workshop Jenkins-Administration mit KI und in den Trainings der Comquent Academy .
- OWASP OWASP Top 10 for Large Language Model Applications: Prompt Injection, Sensitive Information Disclosure, Supply Chain.
- BSI Bundesamt für Sicherheit in der Informationstechnik: Veröffentlichungen zu Chancen und Risiken generativer KI-Modelle sowie zur IT-Sicherheit in der Industrie.
- Bitkom Presseinformation „Beschäftigte nutzen vermehrt Schatten-KI" vom 21. Oktober 2025; telefonische Befragung von 604 Unternehmen ab 20 Beschäftigten in Deutschland, KW 27 bis 32 im Jahr 2025.
- EU-Kommission Regulatory framework for AI: offizielle Einordnung der Risikoklassen des EU AI Act.
- ENISA Agentur der Europäischen Union für Cybersicherheit: Leitlinien zu NIS2 und zur Sicherheit von KI-Systemen.
- ComquentErfahrungen aus lokalen LLM-Deployments für abgeschottete OT-Umgebungen und aus Jenkins-Projekten seit 2006; Hardware-Einordnung nach eigenen Pilotinstallationen 2026.
Häufige Fragen zu
Corporate LLMs.
- Q.01
- Was ist ein Corporate LLM?
- Ein Corporate LLM ist ein Sprachmodell, das ein Unternehmen auf eigener Infrastruktur betreibt und über Retrieval-Augmented Generation an internes Wissen anbindet. Prompts, Dokumente und Antworten verlassen dabei das eigene Netz nicht. Eingesetzt werden offene Modellfamilien auf einem lokalen Inferenz-Server, das Wissen liegt in einem RAG-System mit Vektordatenbank.
- Q.02
- Corporate LLM oder ChatGPT Enterprise: Was ist der Unterschied?
- Der Unterschied liegt in der Architektur. ChatGPT Enterprise schützt Ihre Daten per Vertrag und verarbeitet sie beim Anbieter. Ein Corporate LLM läuft auf eigener Hardware im eigenen Netzsegment, Prompts und Dokumente verlassen das Haus also gar nicht erst. Für air-gap-fähige OT-Umgebungen nach IEC 62443 kommt nur der lokale Betrieb in Frage.
- Q.03
- Funktioniert ein lokales LLM ohne Internetverbindung?
- Ja. Ein lokal betriebenes Modell braucht nach der Installation keine Verbindung nach außen. Inferenz, Vektordatenbank und Wissensquellen laufen im eigenen Netzsegment. Modell- und Software-Updates kommen über kontrollierte, signierte Transferprozesse in die abgeschottete Zone, so wie Betriebssystem-Patches dort auch. Für OT-Netze nach IEC 62443 ist das der einzige gangbare Weg.
- Q.04
- Welche Hardware braucht ein lokales LLM im Unternehmen?
- Für einen Piloten mit einer kleinen Nutzergruppe genügt ein kompaktes System mit 64 bis 128 GB Unified Memory, etwa der Geräteklasse Minisforum AI X1 Pro oder GMKtec EVO-X2. Damit laufen mittelgroße offene Modelle mit RAG im Teambetrieb. Für mehr Nutzer oder größere Modelle folgt ein GPU-Server im Rechenzentrum, die Architektur bleibt dieselbe.
- Q.05
- Was kostet ein Corporate LLM?
- Ein Corporate LLM verursacht statt laufender Token-Kosten eine planbare Hardware-Investition. Für einen Piloten mit kleiner Nutzergruppe genügt ein kompaktes System mit 64 bis 128 GB Unified Memory, darauf laufen mittelgroße offene Modelle mit RAG. Bei wenigen Nutzern ist die Cloud günstiger. Der Business Case entsteht über Datenhoheit und über Skaleneffekte, wenn ganze Teams und Pipelines das Modell nutzen.
- Q.06
- Welche LLMs sind DSGVO-konform?
- Kein Sprachmodell ist von sich aus DSGVO-konform, es kommt auf den Betrieb an. Am einfachsten ist ein offenes Modell auf eigener Hardware, also ein Corporate LLM: kein Auftragsverarbeiter, keine Drittlandübermittlung, Protokolle und Zugriffsrechte unter eigener Kontrolle. Cloud-Dienste brauchen einen Auftragsverarbeitungsvertrag und eine geklärte Drittlandübermittlung. In beiden Fällen gehören Berechtigungen bis auf Dokumentebene und eine mit dem Betriebsrat abgestimmte Protokollierung dazu.
- Q.07
- Was ist Schatten-KI, und hilft ein Corporate LLM dagegen?
- Schatten-KI, englisch Shadow AI, ist die dienstliche Nutzung privater KI-Konten vorbei an IT-Freigabe und Datenschutz. Laut Bitkom-Befragung vom Oktober 2025 kennen 25 Prozent der Unternehmen solche Fälle und weitere 17 Prozent vermuten sie, während erst 23 Prozent überhaupt Regeln dafür aufgestellt haben. Ein Corporate LLM wirkt hier besser als ein Verbot, weil es dieselbe Aufgabe im eigenen Netz erledigt, statt sie nur zu untersagen.
Wie geht es bei Ihnen mit einem Corporate LLM weiter?
Sagen Sie uns mit einem Klick, wie es bei Ihnen weitergeht. Passend dazu bekommen Sie direkt einen konkreten nächsten Schritt — ganz ohne Formular.
Ein Anwendungsfall.Ein Gerät.Sechs Wochen.
Im Erstgespräch klären wir, welcher der vier Anwendungsfälle in Ihren Pipelines zuerst trägt, welches Netzsegment und welche Hardware der Pilot braucht und welche Messkriterien nach sechs Wochen eine Entscheidung ermöglichen.
unverbindlich
Verwandte Artikel
Claude Code im Industrial DevOps: Wo es trägt, wo es endet
Headless in der Pipeline, Legacy verstehen, die Grenze an der SPS und der DSGVO-konforme Deployment-Weg.
Jenkins mit KI steuern: MCP, Vibe Coding & Log-Analyse
Jenkins per MCP-Server mit KI steuern, Pipelines vibecoden und Build-Logs per LLM analysieren.
IndustrialFlow: CI/CD-Plattform für Industrial DevOps
Jenkins-Kern, OT-Proxy-Architektur und lokaler KI-Service, gebaut für Air-Gap-Werke.
Intelligisierung: DevOps-Automatisierung als KI-Fundament
Die Stufe nach Digitalisierung und Automatisierung, und warum sie die ersten drei voraussetzt.
Erstgespräch.
90 Tage zum Ergebnis.
Wir klären gemeinsam, wie Sie in 90 Tagen die ersten messbaren Industrial-DevOps-Erfolge erzielen.
Industrie · Automotive · Finance