
CI/CD vs. GitOps.
Push trifft Pull.
 AI
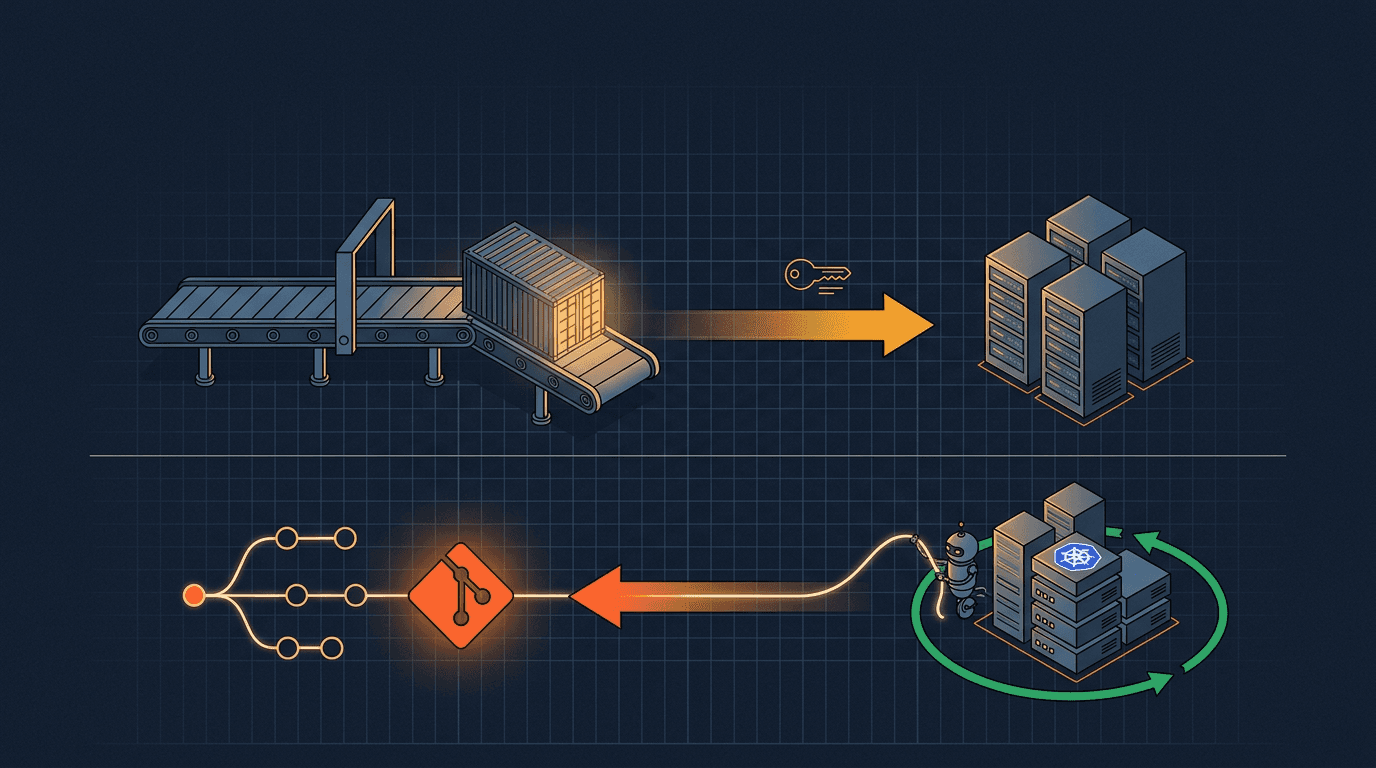
CI/CD und GitOps konkurrieren nicht. GitOps ersetzt nur den Deployment-Teil. Die CI-Pipeline baut und testet weiter und erzeugt das Artefakt. Im klassischen CD schreibt sie das Deployment danach selbst ins Ziel (Push). Bei GitOps steht der gewünschte Zustand deklarativ in Git, und ein Agent im Cluster wie Argo CD oder Flux holt ihn sich, spielt ihn ein und korrigiert Abweichungen (Pull).
Die Pipeline hält die Zugangsdaten zum Cluster und führt das Deployment selbst aus.
Der Agent im Cluster liest den Soll-Zustand aus Git und stellt ihn selbst her, laufend und nachvollziehbar.

Ist GitOps bei Ihnen gerade ein Thema?
Wir fragen kurz, wie dringend das Thema bei Ihnen gerade ist. Je nach Antwort zeigen wir Ihnen direkt den passenden nächsten Schritt — ganz ohne Formular.
Was ist der Unterschied zwischen Push- und Pull-Deployment?
Beim Push-Deployment startet ein System außerhalb der Zielumgebung das Deployment und schreibt die Änderung aktiv hinein. Beim Pull-Deployment läuft ein Agent innerhalb der Zielumgebung, liest den gewünschten Zustand aus einem Git-Repository und stellt ihn selbst her. Der Unterschied ist die Richtung der Verbindung und damit die Frage, wer Zugangsdaten braucht.
Was ist Push-Deployment?
Push-Deployment ist das klassische CD-Modell. Die Pipeline hält die Zugangsdaten zur Zielumgebung und führt den Rollout selbst aus, per kubectl apply, Helm, Ansible oder SSH. Sie bestimmt damit genau, was wann in welcher Reihenfolge passiert. Dafür liegen Cluster-Credentials im Build-System, und die Verbindung geht von außen in die Zielumgebung.
Was ist Pull-Deployment?
Beim Pull-Deployment läuft ein Agent in der Zielumgebung selbst, etwa Argo CD oder Flux im Kubernetes-Cluster. Er beobachtet ein Git-Repository, zieht jede Änderung eigenständig und gleicht den Ist-Zustand laufend an den Soll-Zustand an. Das Build-System braucht dafür keinen Zugriff auf das Cluster.
Ist ein Deployment per git pull schon GitOps?
Nein. Ein Skript, das auf dem Zielserver git pull ausführt, holt zwar den Code, prüft aber nicht laufend, ob der Zustand noch stimmt. GitOps verlangt zusätzlich einen deklarativ beschriebenen Soll-Zustand und einen ständigen Abgleich (Reconciliation). Ohne diesen Abgleich haben Sie ein pull-basiertes Deployment, aber kein GitOps.
In der Praxis fällt die Entscheidung selten grundsätzlich aus. Die meisten Teams bauen weiter push-basiert und rollen pull-basiert aus. Was das für Verantwortung, Sicherheit und Drift bedeutet, zeigt der Direktvergleich.
Worin unterscheiden sich CI/CD und GitOps konkret?
Der Kernunterschied liegt darin, wer deployt. Bei klassischem CI/CD ist es die Pipeline, und die braucht dafür Cluster-Credentials. Bei GitOps ist es ein Agent im Cluster, der Git beobachtet und den deklarierten Zustand selbst herstellt. Die Tabelle zeigt, was daraus für Sicherheit, Drift, Rollback und Nachweise folgt.
Am deutlichsten wird der Unterschied, wenn jemand am Cluster etwas von Hand ändert. Die Zeitleiste zeigt dasselbe Ereignis in beiden Modellen.
Wie sieht der GitOps-Workflow in der Praxis aus?
Die Übergabe zwischen CI/CD und GitOps ist ein einziger Git-Commit. Die CI-Pipeline baut und testet, schreibt das neue Image-Tag ins Config-Repository und ist damit fertig. Den Rest erledigt der Agent im Cluster. Der Ablauf hat drei Schritte:
- /01
Bauen und testen
Die CI baut und testet den Code, führt Security-Scans aus und erzeugt ein Container-Image.
- /02
Soll-Zustand nach Git committen
Die Pipeline aktualisiert das Image-Tag im Config-Repository und committet damit den neuen gewünschten Zustand. Cluster-Credentials braucht sie dafür nicht.
- /03
Agent rollt aus
Der GitOps-Agent (Argo CD oder Flux) erkennt die Änderung in Git, zieht den neuen Zustand und gleicht das Cluster an (Reconciliation).
Von der Architekturfolie lassen sich die wenigsten Teams überzeugen. Überzeugt sind sie nach dem ersten Merge im Config-Repository, wenn die neue Version wenige Minuten später läuft und in der Git-Historie steht, wer sie freigegeben hat.
Das Beispiel zeigt die Übergabe im Code. Links steht die GitLab-CI-Pipeline im Anwendungs-Repository, die das Image baut und den neuen Soll-Zustand committet. Rechts steht das Config-Repository, das Argo CD beobachtet. Die geänderte Zeile newTag löst das Deployment aus. Die Pipeline braucht dafür nur Schreibrechte auf das Config-Repository, auf das Cluster greift sie nie zu.
stages: [build, update-manifest]

build-image:
  stage: build
  script:
    - docker build -t $REGISTRY/shop/api:$CI_COMMIT_SHORT_SHA .
    - docker push $REGISTRY/shop/api:$CI_COMMIT_SHORT_SHA

update-manifest:
  stage: update-manifest
  script:
    # Soll-Zustand ins Config-Repo committen,
    # keine Cluster-Credentials in der CI
    - git clone https://git.example.com/platform/shop-config.git
    - cd shop-config
    - yq -i '.images[0].newTag = env(CI_COMMIT_SHORT_SHA)'
        overlays/prod/kustomization.yaml
    - git commit -am "shop/api -> $CI_COMMIT_SHORT_SHA"
- git push origin mainapiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
resources:
- ../../base
images:
- name: registry.example.com/shop/api
newTag: a1b2c3d # von der CI committet
# Der Agent im Cluster zieht die Änderung selbst:
$ argocd app get shop-prod
Health Status: Healthy
Sync Status: Synced to main (1f4e5d6)
Last Sync: Succeeded (auto, prune, selfHeal)Was ist bei Ihnen der nächste Schritt?
CI/CD und GitOps schließen sich nicht aus. Die Frage ist, was bei Ihnen zuerst dran ist. Zwei Klicks ordnen ein, wo Sie am meisten gewinnen.
Wie deployen Sie heute überwiegend?
Wohin mit Secrets, wenn Git die Quelle ist?
Auf keinen Fall im Klartext ins Repository. Durchgesetzt haben sich drei Ansätze. Sealed Secrets und SOPS legen das Secret verschlüsselt in Git ab. Der External Secrets Operator legt nur einen Verweis ab und holt den Wert zur Laufzeit aus einem Tresor.
Ein einmal committetes Passwort bleibt in der Git-Historie, auch wenn es in der nächsten Version aus der Datei verschwunden ist. Wer das übersieht, rotiert im Ernstfall an einem Wochenende sämtliche Zugangsdaten der Plattform.
 AI
| Ansatz | Was in Git liegt | Wer entschlüsselt | Passt, wenn |
|---|---|---|---|
| Sealed Secrets | Ein SealedSecret, mit kubeseal und dem öffentlichen Schlüssel des Clusters verschlüsselt | Der Controller im Cluster | Wenige Cluster, kein zentraler Tresor |
| SOPS | Die YAML-Datei mit verschlüsselten Werten, die Schlüsselnamen bleiben lesbar (age, PGP oder Cloud-KMS) | Flux direkt, Argo CD über ein Plugin wie KSOPS oder helm-secrets | Im Review soll sichtbar sein, welcher Eintrag sich geändert hat |
| External Secrets Operator | Nur ein ExternalSecret mit Verweis auf den Tresor, kein Wert | Der Operator holt den Wert aus HashiCorp Vault, AWS, Azure oder Google Cloud | Ein Tresor existiert bereits oder Rotation ist Pflicht |
Wo es bereits einen Tresor gibt, nehmen wir den External Secrets Operator. Git enthält dann gar keine Geheimnisse, auch keine verschlüsselten, und die Rotation passiert an einer einzigen Stelle. Sealed Secrets ist der schnellere Start für ein einzelnes Cluster. Sichern Sie dann aber den privaten Schlüssel des Controllers, denn nach einem Neuaufbau des Clusters lässt sich ohne ihn keines der Secrets mehr entschlüsseln. Treffen Sie die Wahl vor der ersten produktiven Anwendung, ein späterer Wechsel betrifft jedes Secret einzeln. Wie sich das in eine sichere Lieferkette einfügt, beschreibt unsere Seite zu DevSecOps.
Welche Nachteile und Grenzen hat GitOps?
GitOps erkauft Sicherheit und Nachvollziehbarkeit mit zusätzlichen Bausteinen. Neben der Secret-Frage aus Abschnitt 05 gehören drei Grenzen vor der Einführung auf den Tisch.
Höhere Einstiegskomplexität
Config-Repository, ein Agent im Cluster und ein sauberes Branching-Modell müssen erst stehen. Teams ohne Kubernetes-Erfahrung zahlen eine spürbare Lernkurve, bevor der erste produktive Sync läuft.
Config-Sprawl bei vielen Umgebungen
Jede Umgebung und jedes Cluster lebt als eigener deklarativer Zustand in Git. Ohne Kustomize-Overlays oder eine durchdachte Repo-Struktur wächst der Pflegeaufwand mit jeder Umgebung.
Overkill bei einfachen Deployments
Für eine einzelne VM, eine Server-Anwendung ohne Kubernetes oder ein kleines Setup bringt das Pull-Modell wenig. Dort bleibt klassisches Push-CD die schnellere Wahl.
Unsere Faustregel: GitOps zahlt sich aus, sobald Kubernetes im Spiel ist, mehrere Cluster gepflegt werden oder ein Audit ansteht. Spätestens wenn ein Auditor wissen will, wer die letzte Änderung in Produktion freigegeben hat, ist die Git-Historie mehr wert als jede nachgepflegte Dokumentation.
 AI
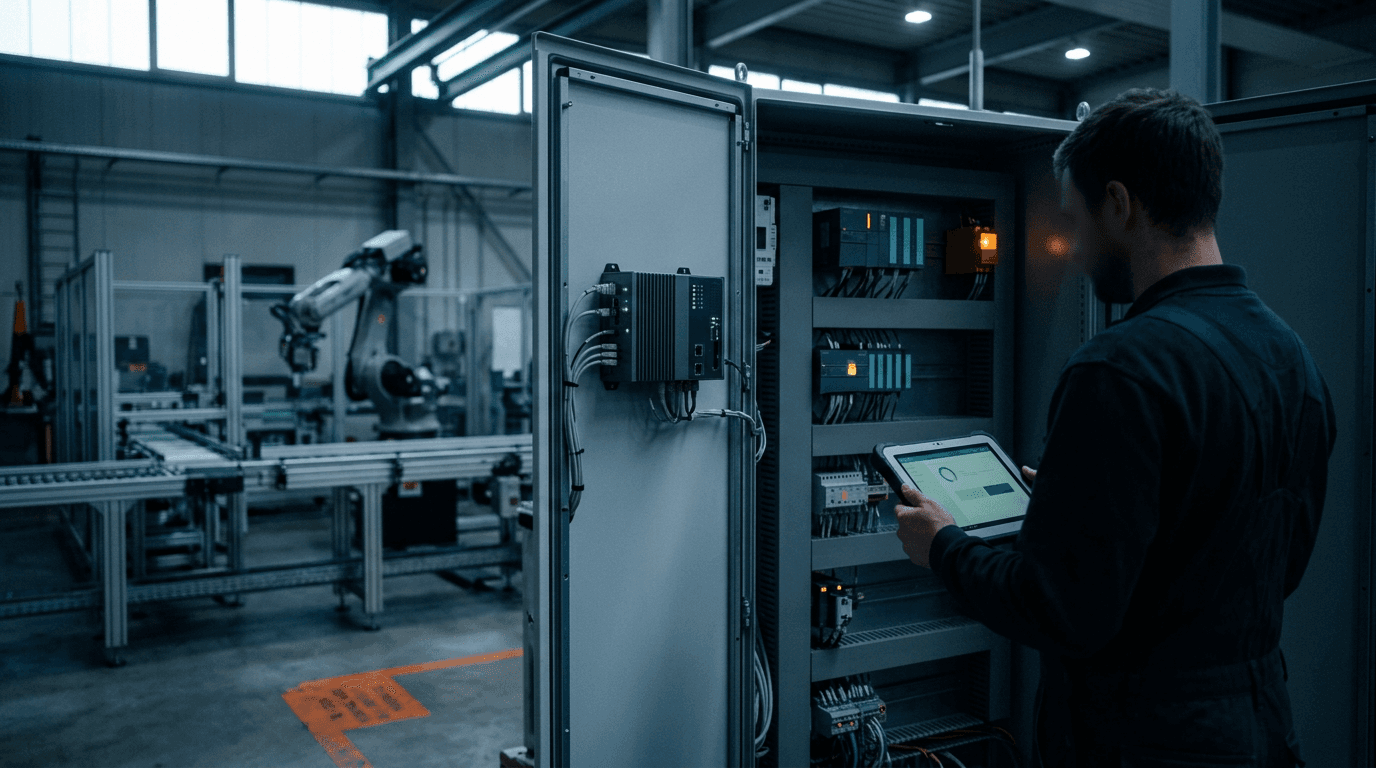
In Werken kommt ein weiteres Argument dazu. Edge-Cluster hängen dort oft hinter restriktiven Firewalls oder laufen ganz ohne Verbindung nach außen (Air-Gap). Mit dem Pull-Prinzip holt sich der Cluster seinen Soll-Zustand selbst, etwa aus einem internen Git-Spiegel, und keine Pipeline muss von außen ins OT-Netz. Wie das zu den Zonen der IEC 62443 passt, beschreibt GitOps in der Industrie.
Welche Stolpersteine gibt es beim Umstieg auf GitOps?
Die häufigsten Fehler beim Umstieg sind organisatorisch. Die Technik läuft meist nach wenigen Tagen, die Arbeitsweise braucht länger.
Der typische Anfang sieht so aus: Die Manifeste liegen in einem Ordner k8s/ im Anwendungs-Repository, und die Pipeline ruft am Ende kubectl apply auf. Das hält, bis jemand nur die Zahl der Replicas ändern will und dafür einen kompletten Build mit allen Tests abwarten muss.
App- und Config-Repo nicht trennen
Liegen die Manifeste im Anwendungs-Repository, löst jeder Code-Commit ein Deployment aus, und Infrastruktur-Änderungen lassen sich nicht separat reviewen. Ein eigenes Config-Repository pro Plattform oder Team entkoppelt Release-Takt und Deployment-Freigabe.
Image-Tags von Hand pflegen
Wer nach jedem Build das Tag im Config-Repository selbst ändert, baut eine manuelle Brücke mitten in die Automatisierung. Einer der drei Wege aus Abschnitt 04 gehört von Anfang an dazu.
Rollbacks in Pipeline-Logik denken
Ein GitOps-Rollback ist ein git revert, keine erneute Pipeline-Ausführung. Teams, die für den Notfall weiter eine Pipeline „alte Version deployen“ mit Cluster-Zugriff pflegen, unterlaufen das Pull-Modell und schaffen einen zweiten Deployment-Pfad, den niemand mehr nachvollziehen kann.
Sie wollen wissen, wo Ihre Delivery-Kette heute steht, bevor Sie GitOps einplanen? Der DevOps-Reifegrad-Check zeigt es in 15 Minuten, ohne Anmeldung. Wer den Umstieg mit dem eigenen Team üben will, findet im ArgoCD- und GitOps-Workshop zwei Tage Praxis in einer vorbereiteten Cluster-Umgebung.
Häufige Fragen zu CI/CD, GitOps und Deployment-Modellen
Was ist der Unterschied zwischen CI/CD und GitOps?
CI/CD ist die automatisierte Kette aus Build, Test und Auslieferung, bei der die Pipeline das Deployment klassisch selbst ins Ziel schreibt (Push). GitOps ändert nur den Auslieferungsteil: Der gewünschte Zustand steht deklarativ in Git, und ein Agent wie Argo CD oder Flux holt ihn sich und gleicht das Cluster laufend an (Pull). GitOps ersetzt also nicht CI/CD, sondern das push-basierte CD.
Was ist CI/CD einfach erklärt?
CI/CD ist die automatisierte Kette von der Code-Änderung bis zur laufenden Anwendung. Continuous Integration (CI) baut den Code, führt Tests und Security-Scans aus und erzeugt ein Artefakt, zum Beispiel ein Container-Image. Continuous Delivery beziehungsweise Continuous Deployment (CD) bringt dieses Artefakt automatisiert in die Zielumgebung, sodass niemand mehr von Hand baut, kopiert oder einspielt.
Was ist GitOps einfach erklärt?
GitOps ist ein Betriebsmodell, das den gewünschten Zustand von Infrastruktur und Anwendungen deklarativ in einem Git-Repository festhält und von einem Agenten (Argo CD, Flux) laufend mit dem System abgleichen lässt. Git ist damit die einzige Quelle der Wahrheit (Single Source of Truth). Jede Änderung ist ein Commit, jeder Rollback ein git revert, und Abweichungen zwischen Soll- und Ist-Zustand (Drift) korrigiert der Agent automatisch.
Was sind die vier Prinzipien von GitOps?
Die OpenGitOps-Initiative definiert vier Prinzipien. 1) Deklarativ: Beschrieben wird der gewünschte Zustand, nicht der Weg dorthin. 2) Versioniert und unveränderlich: Der Zustand liegt in Git, jede Version bleibt nachvollziehbar erhalten. 3) Automatisch gezogen: Ein Agent holt den Soll-Zustand selbst, statt dass eine Pipeline von außen pusht. 4) Kontinuierlich abgeglichen: Der Agent überwacht laufend und korrigiert Drift. Aus diesen vier Prinzipien folgt, dass GitOps auditierbar ist und sich selbst repariert.
Ist GitOps Push oder Pull?
GitOps ist pull-basiert. Ein Agent im Cluster beobachtet das Git-Repository und zieht Änderungen selbst, statt dass eine externe Pipeline mit Cluster-Zugangsdaten pusht. Die CI braucht dadurch keine Cluster-Credentials, und der Agent kann Drift automatisch korrigieren.
Ist ArgoCD push- oder pull-basiert?
Argo CD ist pull-basiert. Der Controller läuft im Kubernetes-Cluster, beobachtet das Config-Repository und wendet Änderungen von innen an. Mit der Option selfHeal setzt er zusätzlich manuelle Eingriffe am Cluster zurück. Einen manuellen Sync über CLI oder Weboberfläche gibt es zwar, der Abgleich selbst bleibt aber ein Pull aus Git.
Welche Deployment-Werkzeuge arbeiten push-basiert, welche pull-basiert?
Push-basiert arbeiten Jenkins, GitLab CI, GitHub Actions und Azure Pipelines, ebenso Ansible und Terraform. Sie halten die Zugangsdaten und schreiben die Änderung aktiv in die Zielumgebung. Pull-basiert arbeiten die GitOps-Agenten Argo CD und Flux, die im Cluster laufen und den Soll-Zustand selbst aus Git holen. Beide Modelle lassen sich kombinieren: Die Pipeline baut, der Agent rollt aus.
Wann ist Push-Deployment die bessere Wahl als Pull?
Push bleibt die bessere Wahl ohne Kubernetes, bei wenigen Zielsystemen und überall dort, wo der Rollout an eine feste Reihenfolge gebunden ist, etwa an eine Datenbank-Migration vor dem Anwendungs-Deployment. Auch für seltene Deployments lohnt sich der Betrieb eines Agenten selten. Pull-Deployment mit GitOps spielt seine Stärken bei Kubernetes, mehreren Clustern und regulierten Branchen aus.
Ersetzt GitOps die CI/CD-Pipeline?
Nein, GitOps ersetzt nur den Deployment-Teil (CD). Continuous Integration mit Build, Tests, Security-Scans und Image-Erstellung bleibt nötig und läuft weiter in Jenkins, GitLab CI oder GitHub Actions. Die CI committet anschließend den neuen gewünschten Zustand nach Git, und GitOps übernimmt von dort.
Was ist ein Config-Repository und warum braucht GitOps eines?
Das Config-Repository hält den gewünschten Cluster-Zustand, also Kubernetes-Manifeste, Kustomize-Overlays oder Helm-Values, getrennt vom Anwendungscode. Die Trennung verhindert, dass jeder Code-Commit ein Deployment auslöst, und erlaubt eigene Reviews und Freigaben für Infrastruktur-Änderungen. Der GitOps-Agent beobachtet nur dieses Repository.
Was macht der Argo CD Image Updater?
Der Argo CD Image Updater beobachtet Container-Registries und aktualisiert das Image-Tag einer Argo-CD-Anwendung, sobald nach den festgelegten Regeln eine neue Version verfügbar ist. Die Änderung schreibt er über die Argo-CD-API oder als Commit ins Git-Repository zurück. Seit Version 1.0 steht seine Konfiguration in einer eigenen ImageUpdater-Ressource. Er arbeitet mit Kustomize-, Helm- und Plugin-Anwendungen, und das Projekt empfiehlt ihn noch nicht für kritische Produktions-Workloads.
Wie verwaltet man Secrets bei GitOps?
Verschlüsselt oder als Verweis, nie im Klartext. Sealed Secrets und SOPS legen Secrets verschlüsselt in Git ab. Der External Secrets Operator legt nur einen Verweis ab und holt den Wert zur Laufzeit aus einem Tresor wie HashiCorp Vault, AWS Secrets Manager oder Azure Key Vault. Wo ein Tresor existiert, ist der External Secrets Operator meist die sauberere Wahl, weil Git dann gar keine Geheimnisse enthält.
Wie funktionieren Rollbacks mit GitOps?
Ein Rollback ist ein git revert auf dem Config-Repository. Der alte Zustand wird als neuer Commit deklariert, und der Agent gleicht das Cluster automatisch an. Dafür braucht es weder eine eigene Rollback-Pipeline noch manuellen Cluster-Zugriff, und die Git-Historie dokumentiert, wer wann was zurückgerollt hat.
Was ist ein wesentlicher Nachteil von GitOps?
Der größte Nachteil ist die zusätzliche Komplexität. GitOps verlangt ein separates Config-Repository, einen Agenten im Cluster und eine Secret-Strategie (Sealed Secrets, SOPS oder External Secrets). Bei vielen Umgebungen wächst die Config-Pflege spürbar, und für einfache Deployments ohne Kubernetes ist klassisches Push-CD oft die pragmatischere Wahl. GitOps zahlt sich vor allem mit Kubernetes, mehreren Clustern oder in regulierten Branchen aus.
Ist Git ein CI/CD-Tool?
Nein, Git ist ein Versionskontrollsystem. CI/CD-Werkzeuge wie Jenkins, GitLab CI oder GitHub Actions setzen auf Git auf: Ein Commit oder Merge-Request startet die Pipeline. Bei GitOps wird Git zusätzlich zur deklarativen Source of Truth für den Cluster-Zustand. Das Deployment selbst übernimmt aber ein Agent wie Argo CD oder Flux.
Wie geht es bei Ihnen mit GitOps weiter?
Sagen Sie uns mit einem Klick, wie es bei Ihnen weitergeht. Passend dazu bekommen Sie direkt einen konkreten nächsten Schritt — ganz ohne Formular.
Verwandte Artikel
ArgoCD vs. Flux: GitOps-Tools im Vergleich 2026
Welches GitOps-Tool passt zu Ihrem Kubernetes-Setup?
Jenkins vs. GitLab vs. GitHub Actions vs. Azure DevOps
CI/CD-Plattformen im ehrlichen Vergleich.
IndustrialFlow: industrielles CI/CD als eigenes Werkzeug
GitOps und CI/CD air-gap-fähig für die OT.
Erstgespräch.
Kostenlos.
90 Tage zum Ergebnis.
Wir klären gemeinsam, wie Sie in 90 Tagen die ersten messbaren Industrial-DevOps-Erfolge erzielen.
Industrie · Automotive · Finance